视频模型越高清、越长,Attention 就越像“显卡税”:算得最多,却不容易靠低比特真正跑快。
Nunchux AI、MIT、NVIDIA 等作者提出的 VC-Attention,把优化重点从常见的 Query/Key 转向更棘手的 Value,并顺手处理了 Softmax 的速度瓶颈。
它有两招:
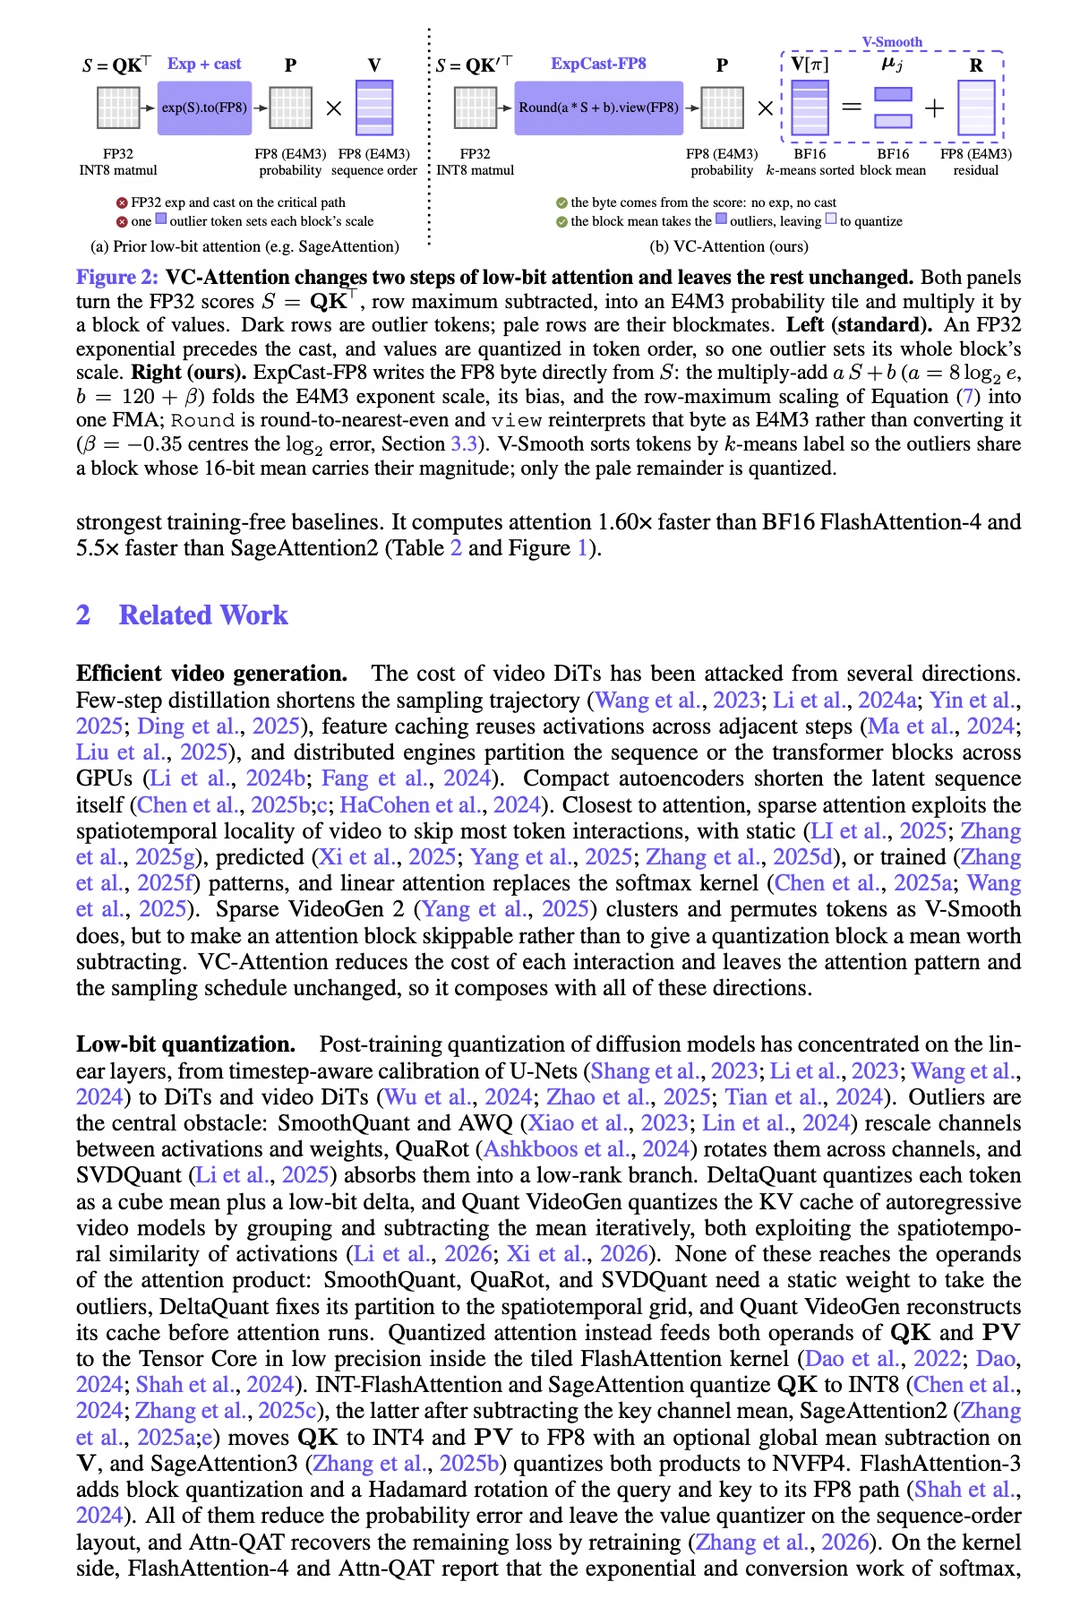
1. V-Smooth:在线 k-means 把数值相近的 Value token 放进同一硬件块,减去块均值后只量化残差;利用 online softmax 已有的行和把均值补回,因此不改变注意力输出。
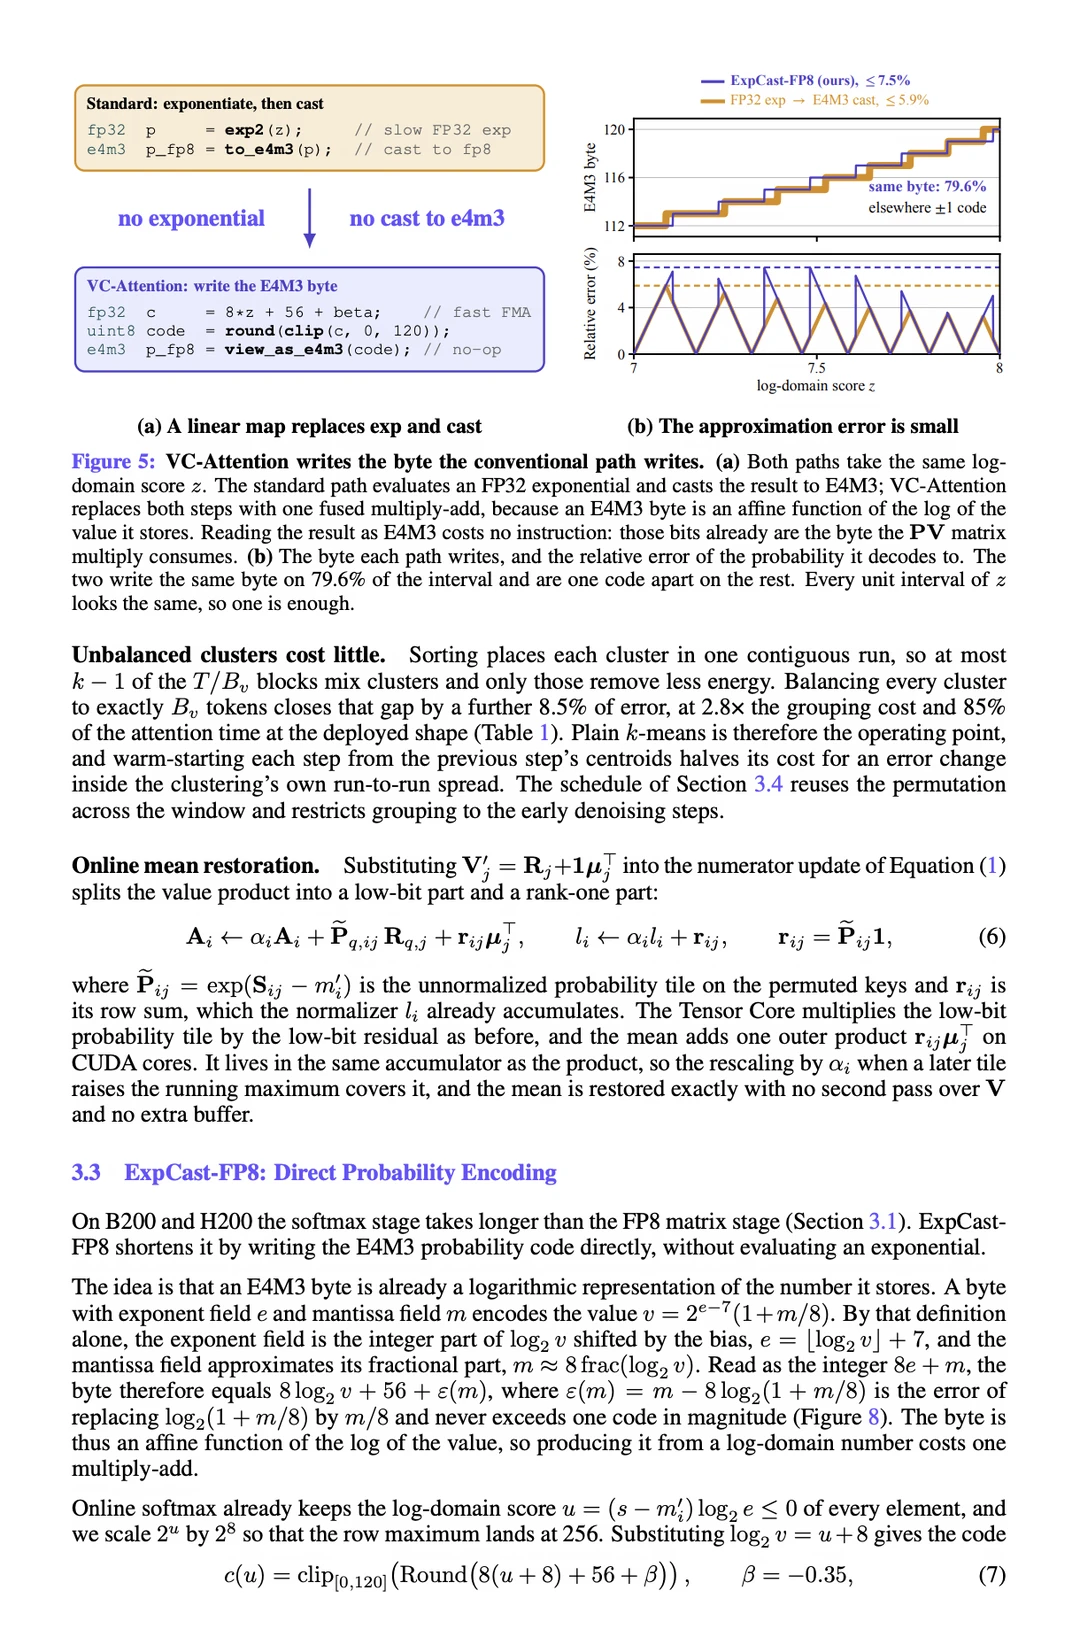
2. ExpCast-FP8:不再先算 FP32 exponential 再转 FP8,而是从对数域分数直接写出 E4M3 概率编码,减少 Softmax 的关键路径开销。
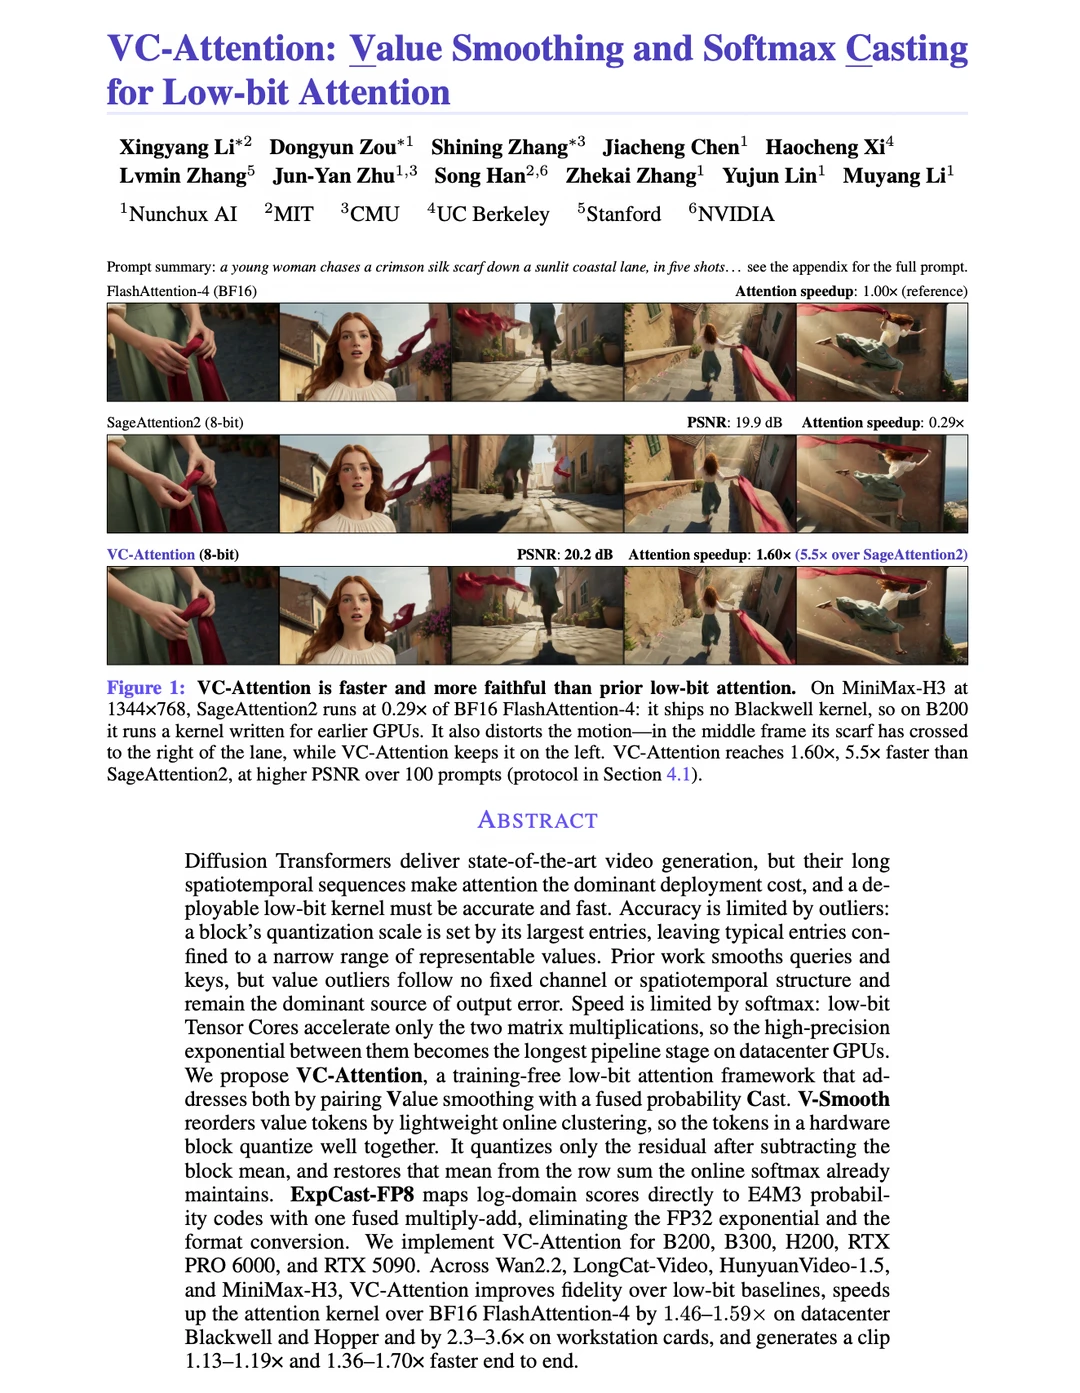
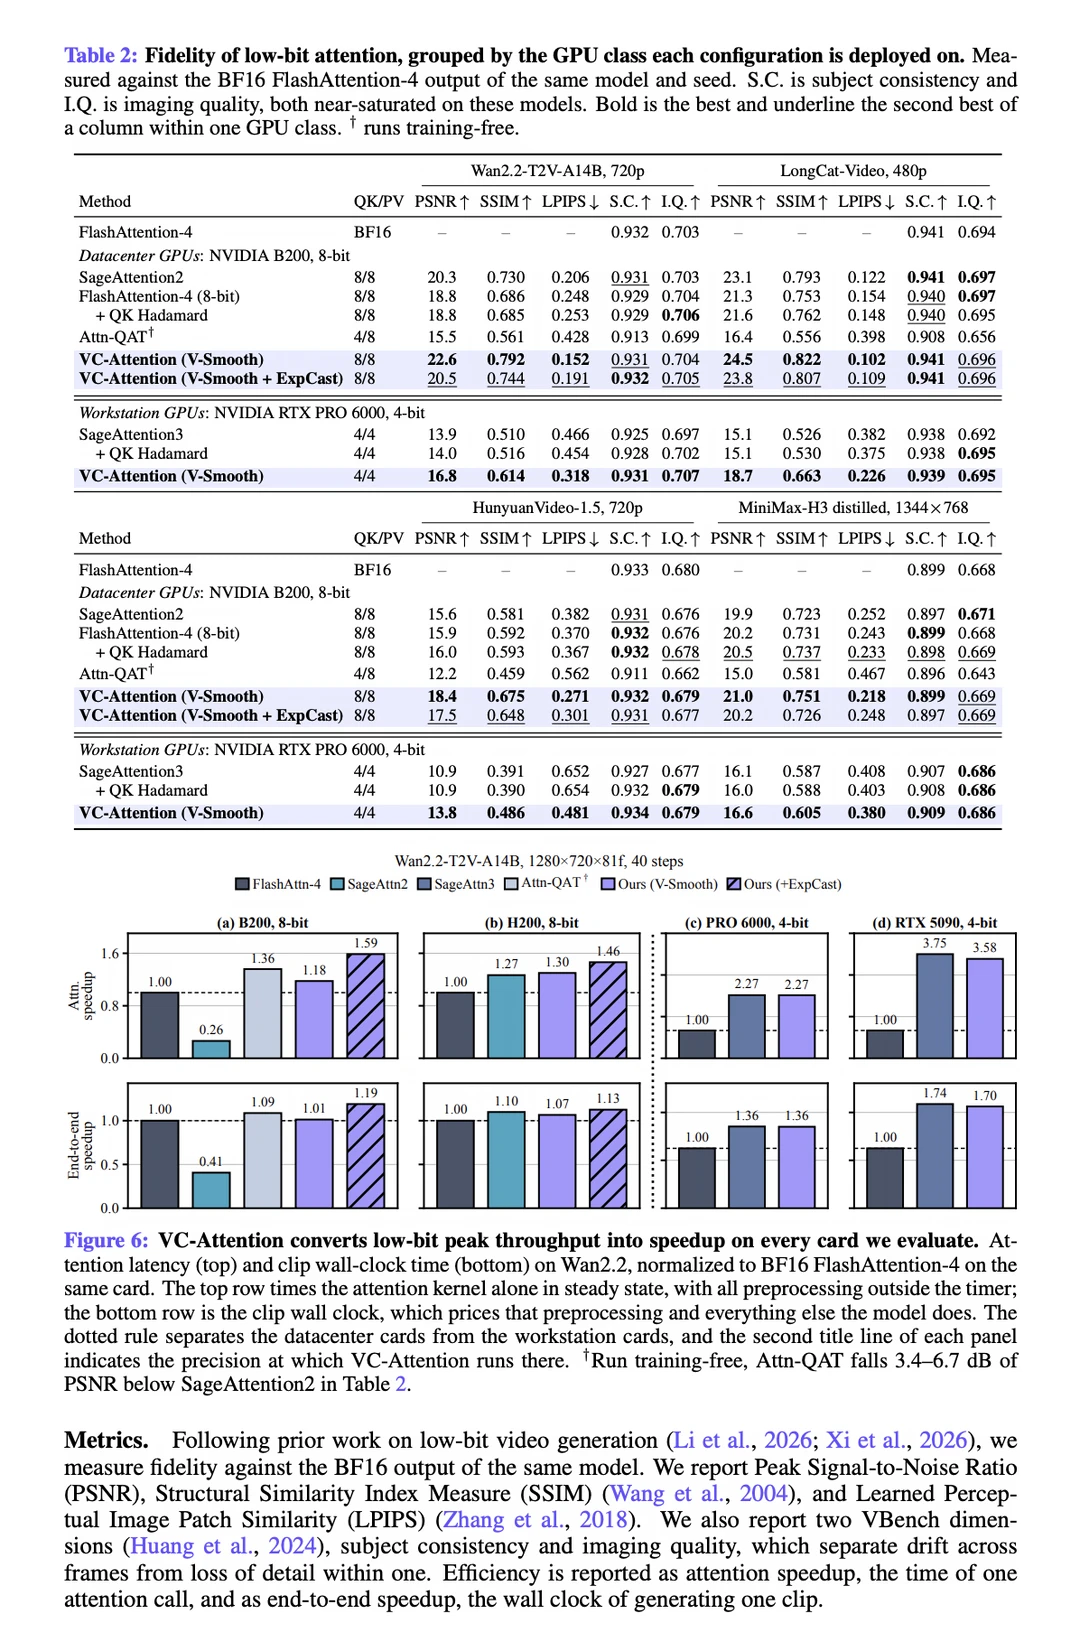
在 Wan2.2、LongCat-Video、HunyuanVideo-1.5、MiniMax-H3 上,8-bit 的完整方案相对 BF16 FlashAttention-4,Attention kernel 在 B200/H200 上快 1.59×/1.46×;端到端生成单条 Wan2.2 视频快 1.19×/1.13×。
工作站 Blackwell 上仅用 V-Smooth 的 4-bit 版本,RTX 5090 的 Attention 达到 3.58×、端到端达到 1.70×。
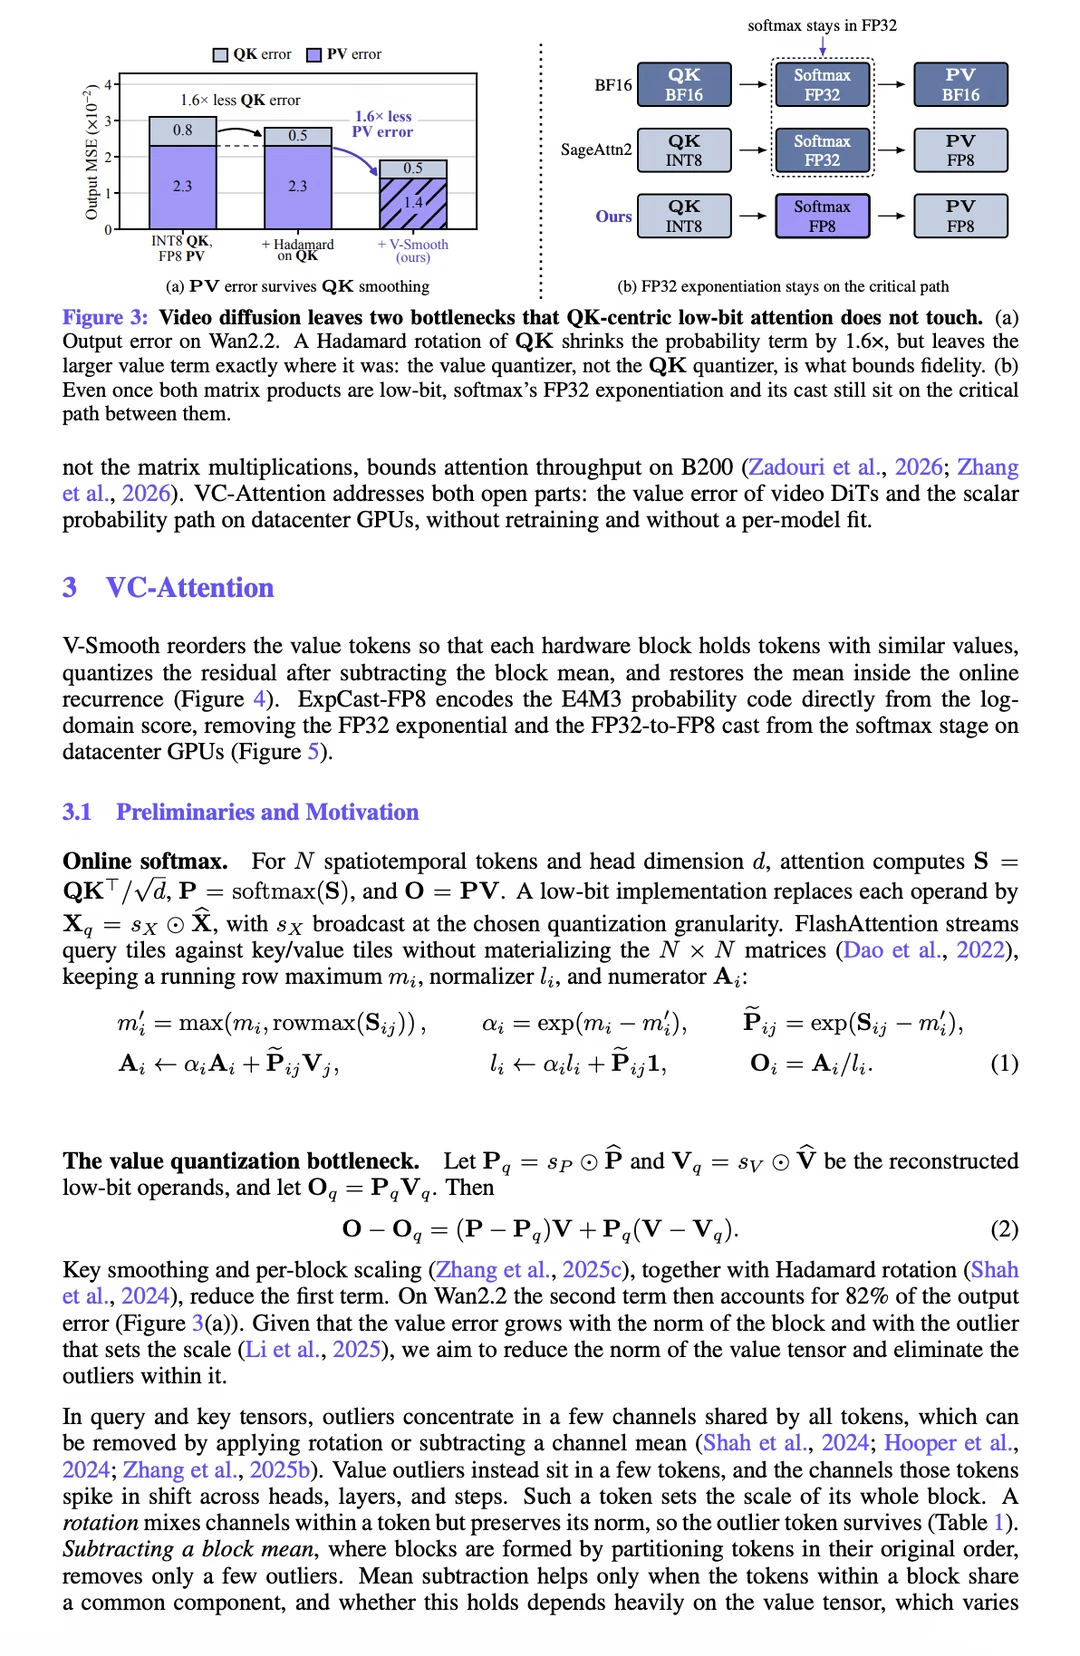
论文指出,QK 已被大量工作优化后,视频 DiT 的主要误差会落到 Value 量化;而低比特矩阵乘快了,Softmax 反而可能成为新瓶颈。
VC-Attention 是一次针对这两个剩余瓶颈的工程化回答。
适合做视频生成推理、FlashAttention kernel、低比特量化的读者重点看,论文给大家上传到附件啦~
#视频生成 #DiT #Attention #低比特量化 #FlashAttention #FP8 #CUDA #推理优化