小模型蒸馏通常沿用教师模型的 tokenizer:大模型按 token 输出概率,小模型也按 token 学。
但这条路径有两个隐性成本:十万级词表的 logits 很难完整保存,只能存 top-k;而 token 边界本身,也把模型限制在既定分词方案里。
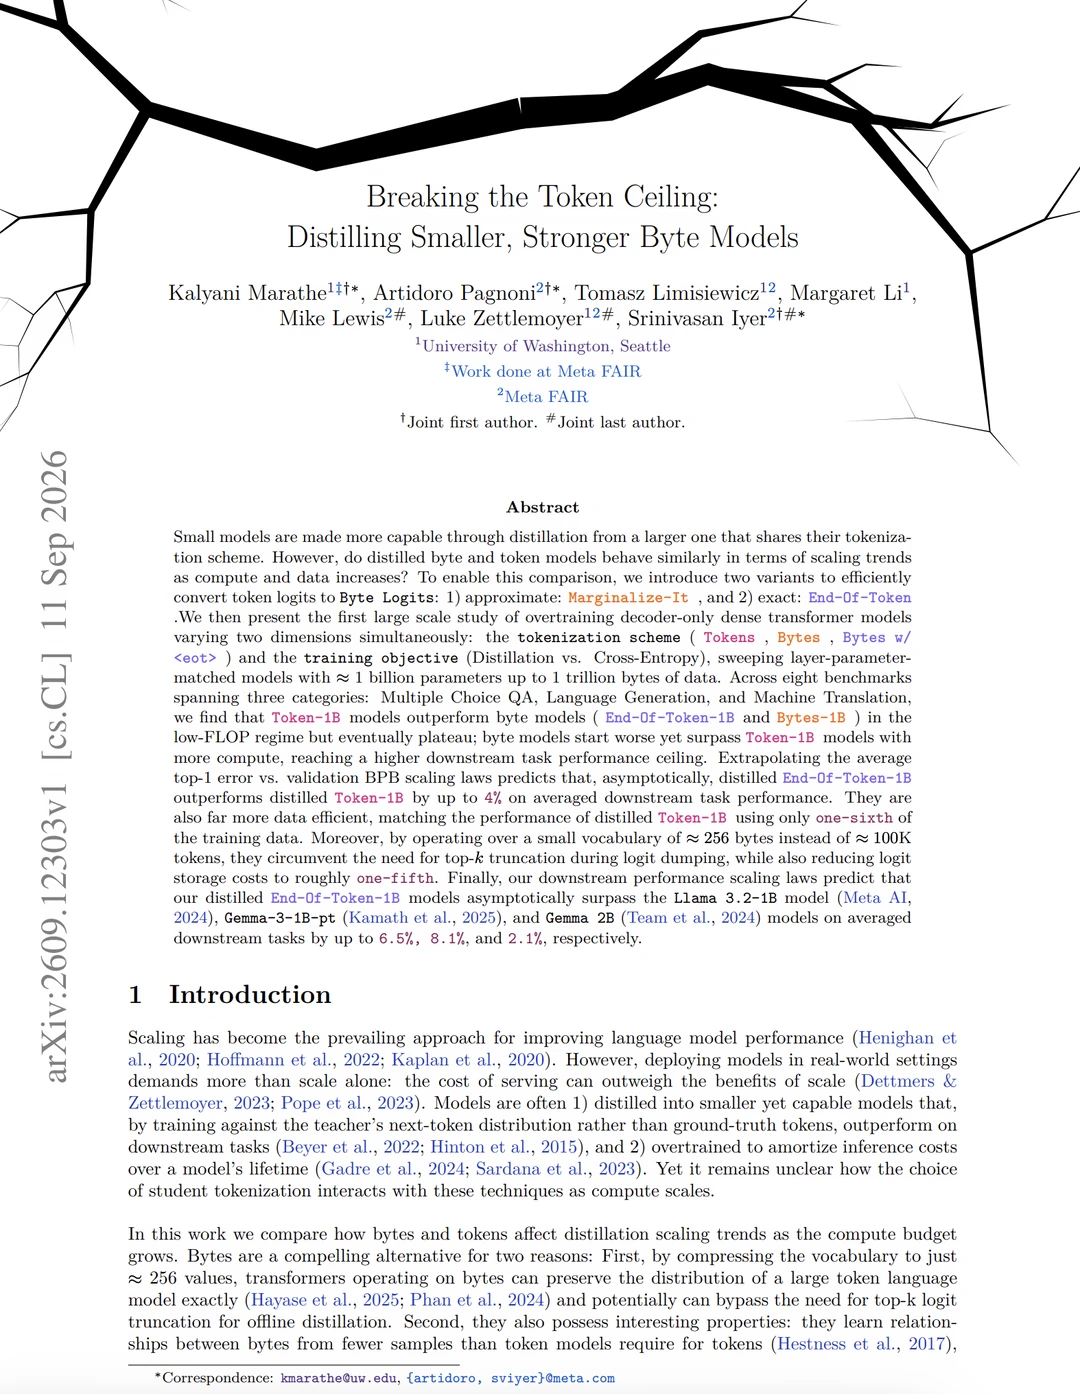
Meta FAIR 与华盛顿大学这篇工作提出:把 token 模型教师蒸馏成 byte-level 学生。
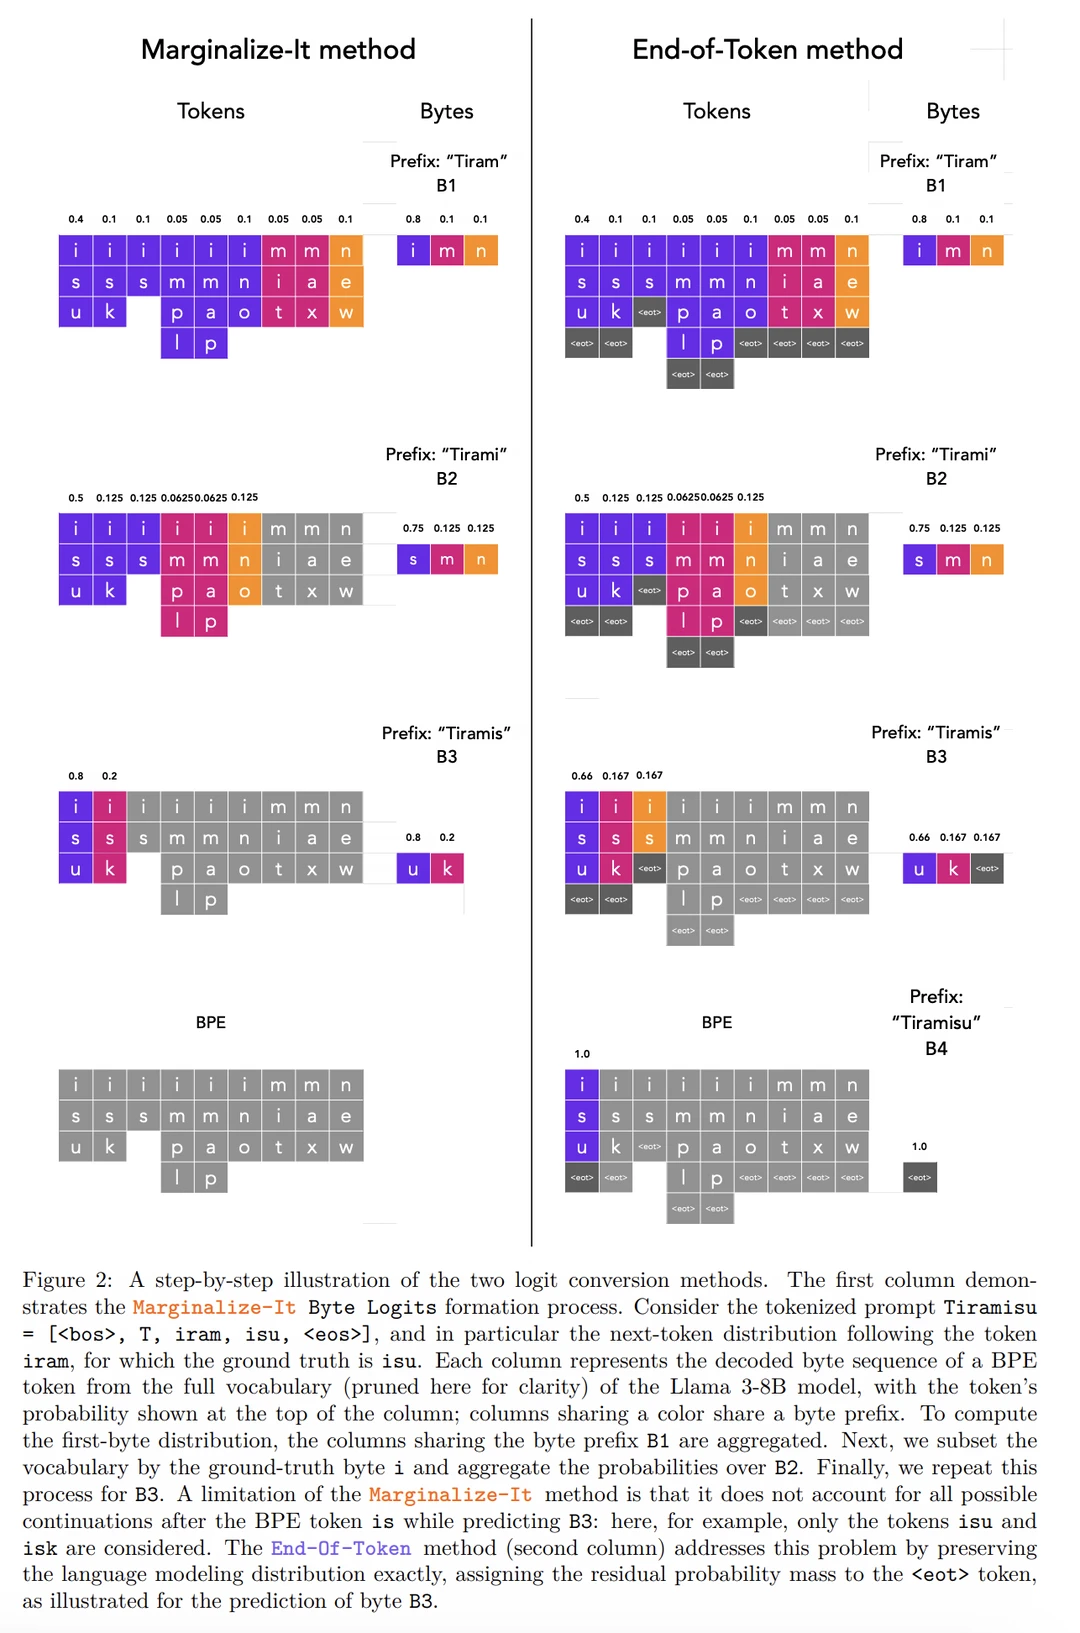
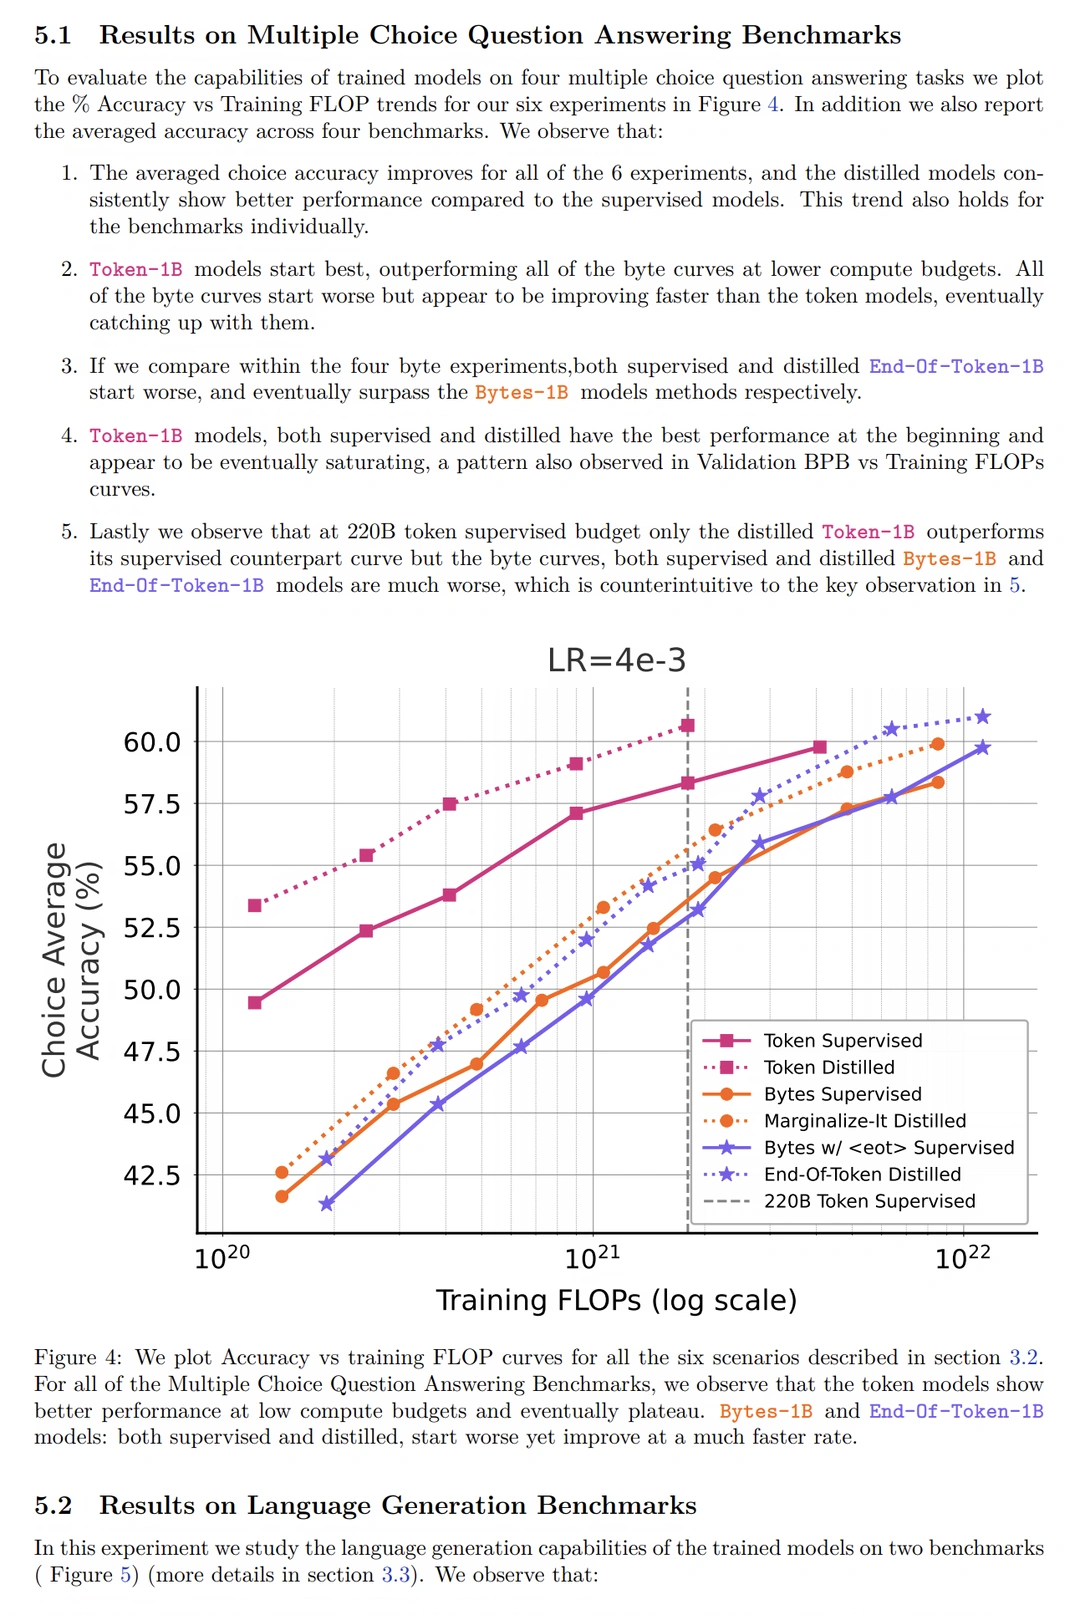
其关键是把教师的 token logits 转成 byte logits,并提出两种单次前向即可完成的转换方式:
- Marginalize-It:按字节前缀聚合概率,速度可行,但后续字节概率是近似值。
- End-Of-Token:在每个原 BPE token 后插入 ,把“token 在此结束”的概率显式保留,从而精确保留教师分布。
- 字节词表只约 260 个符号,相比约 12.8 万 token,可存完整分布,避免 top-k 截断。
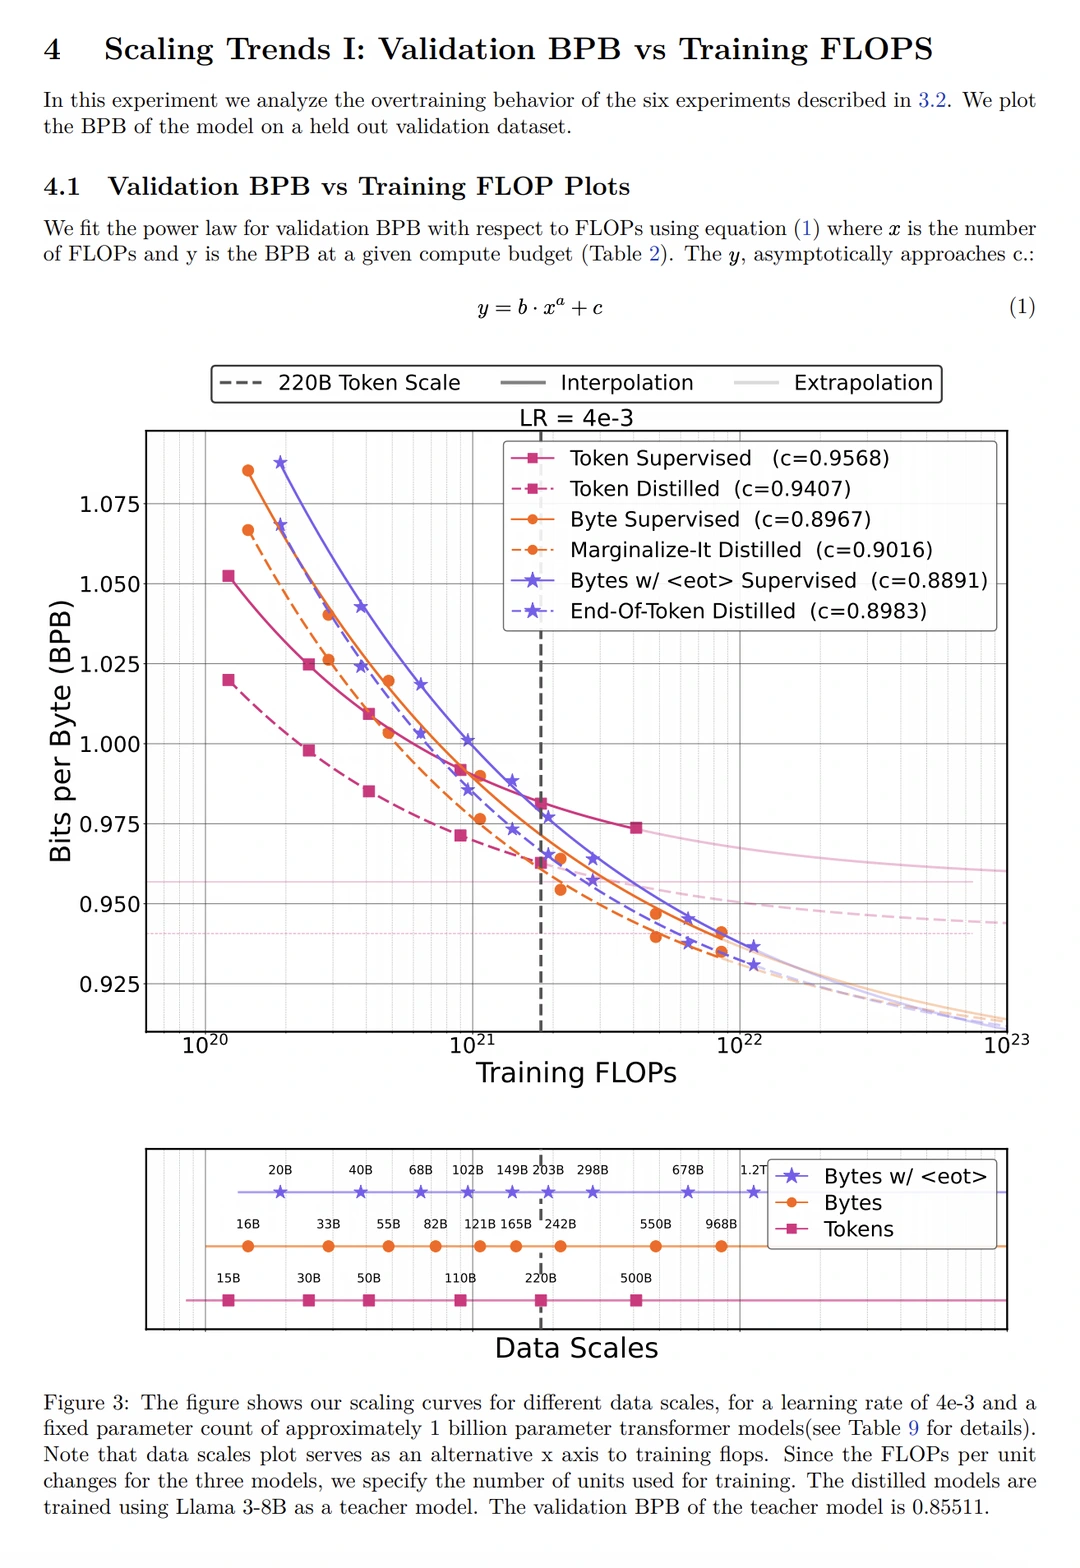
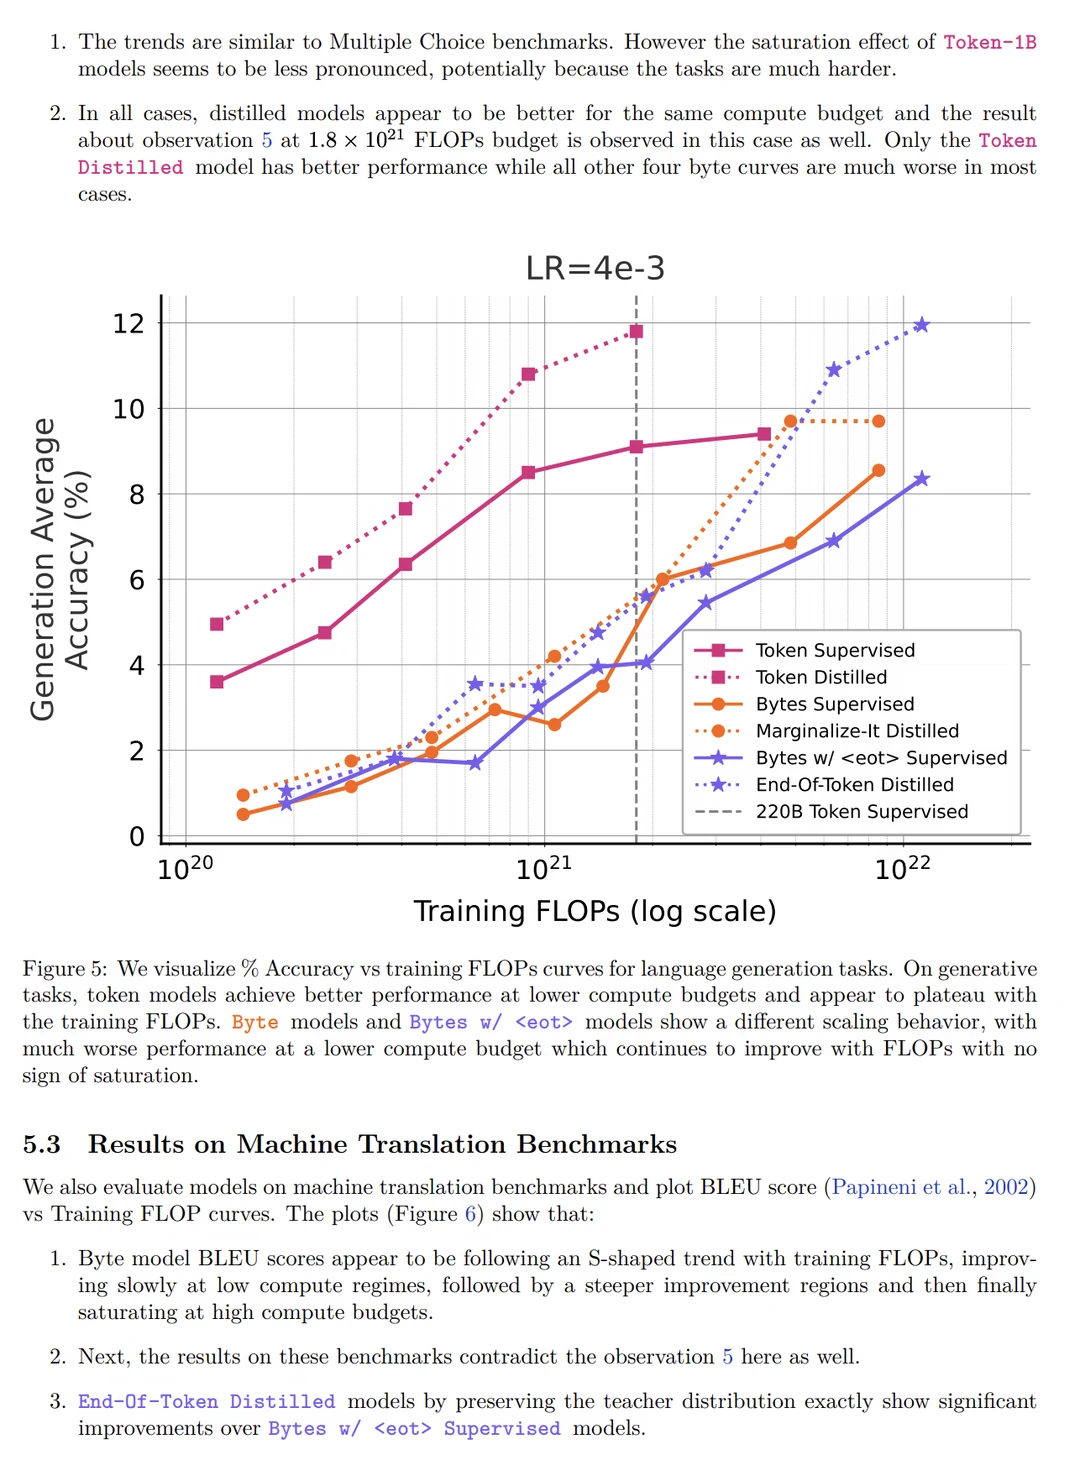
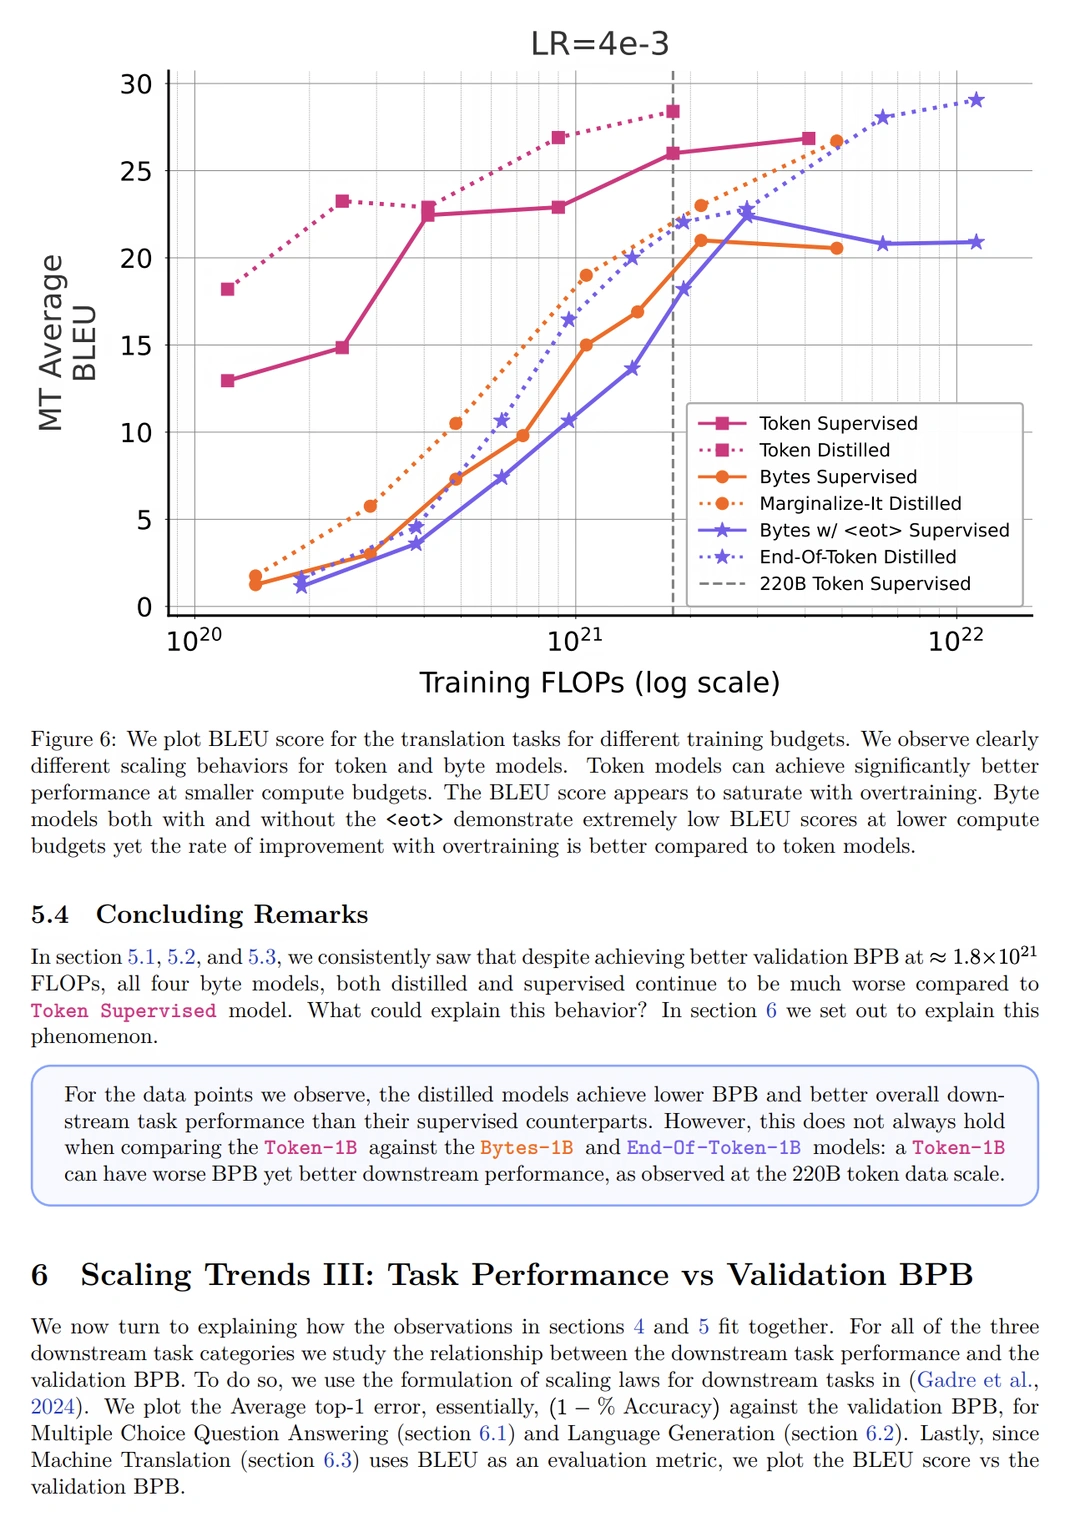
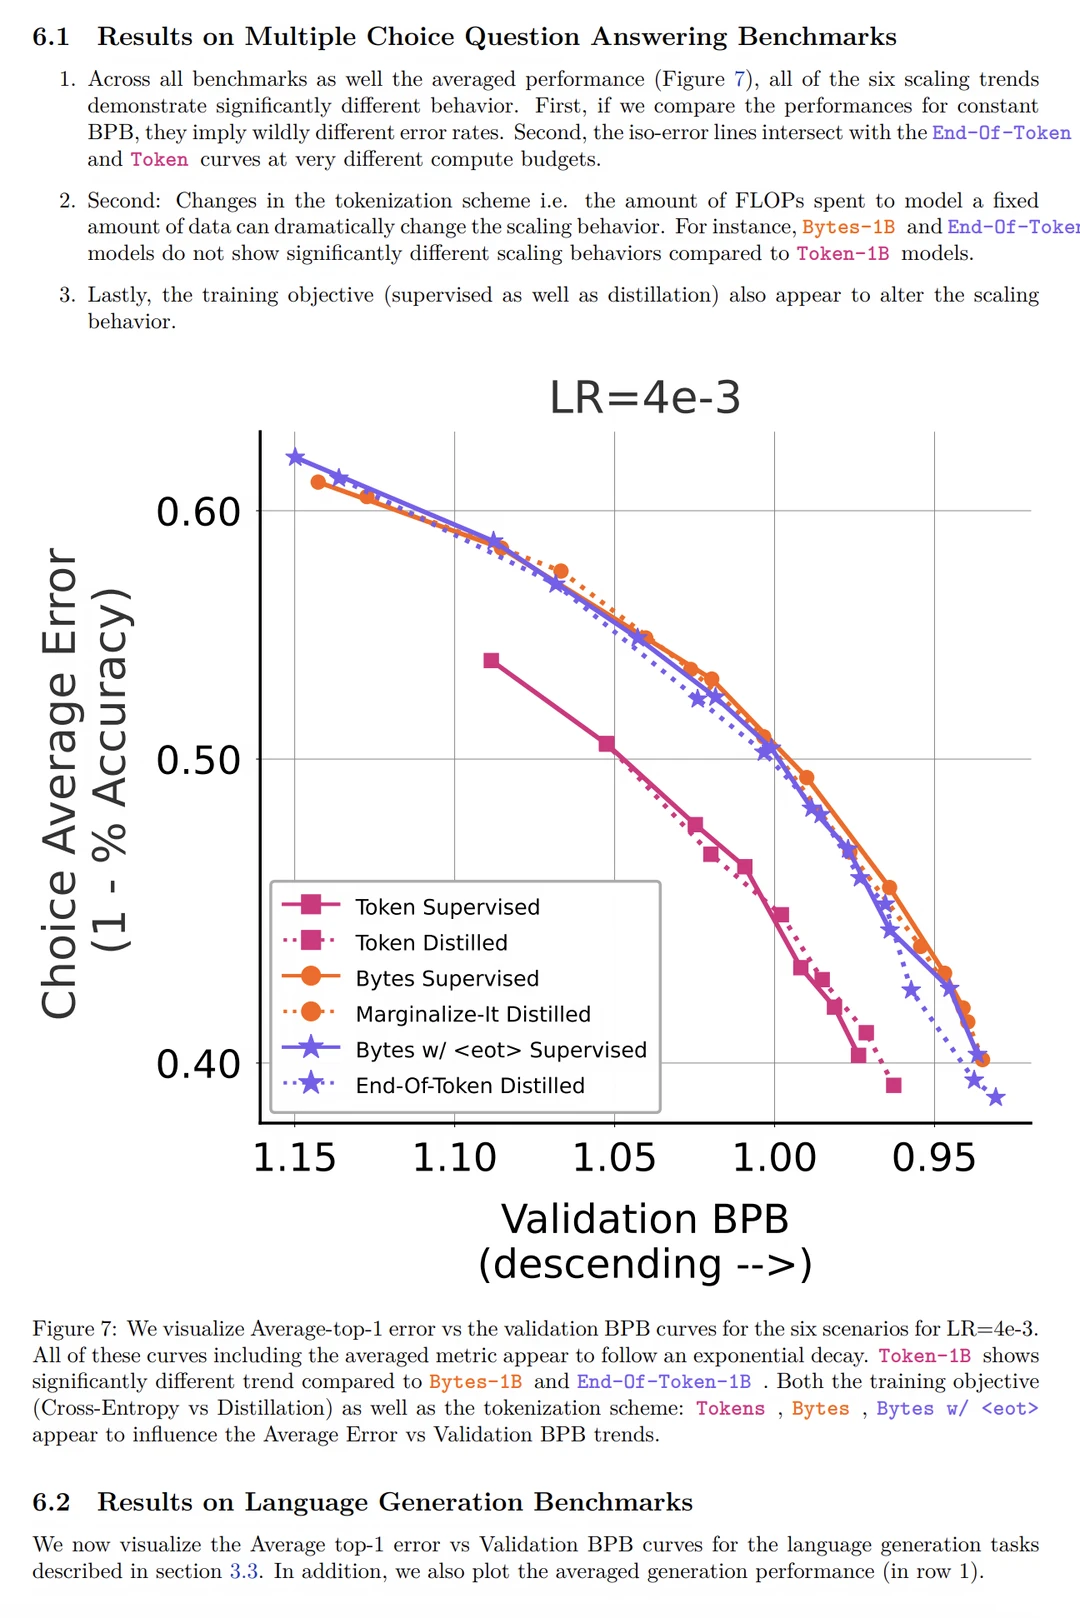
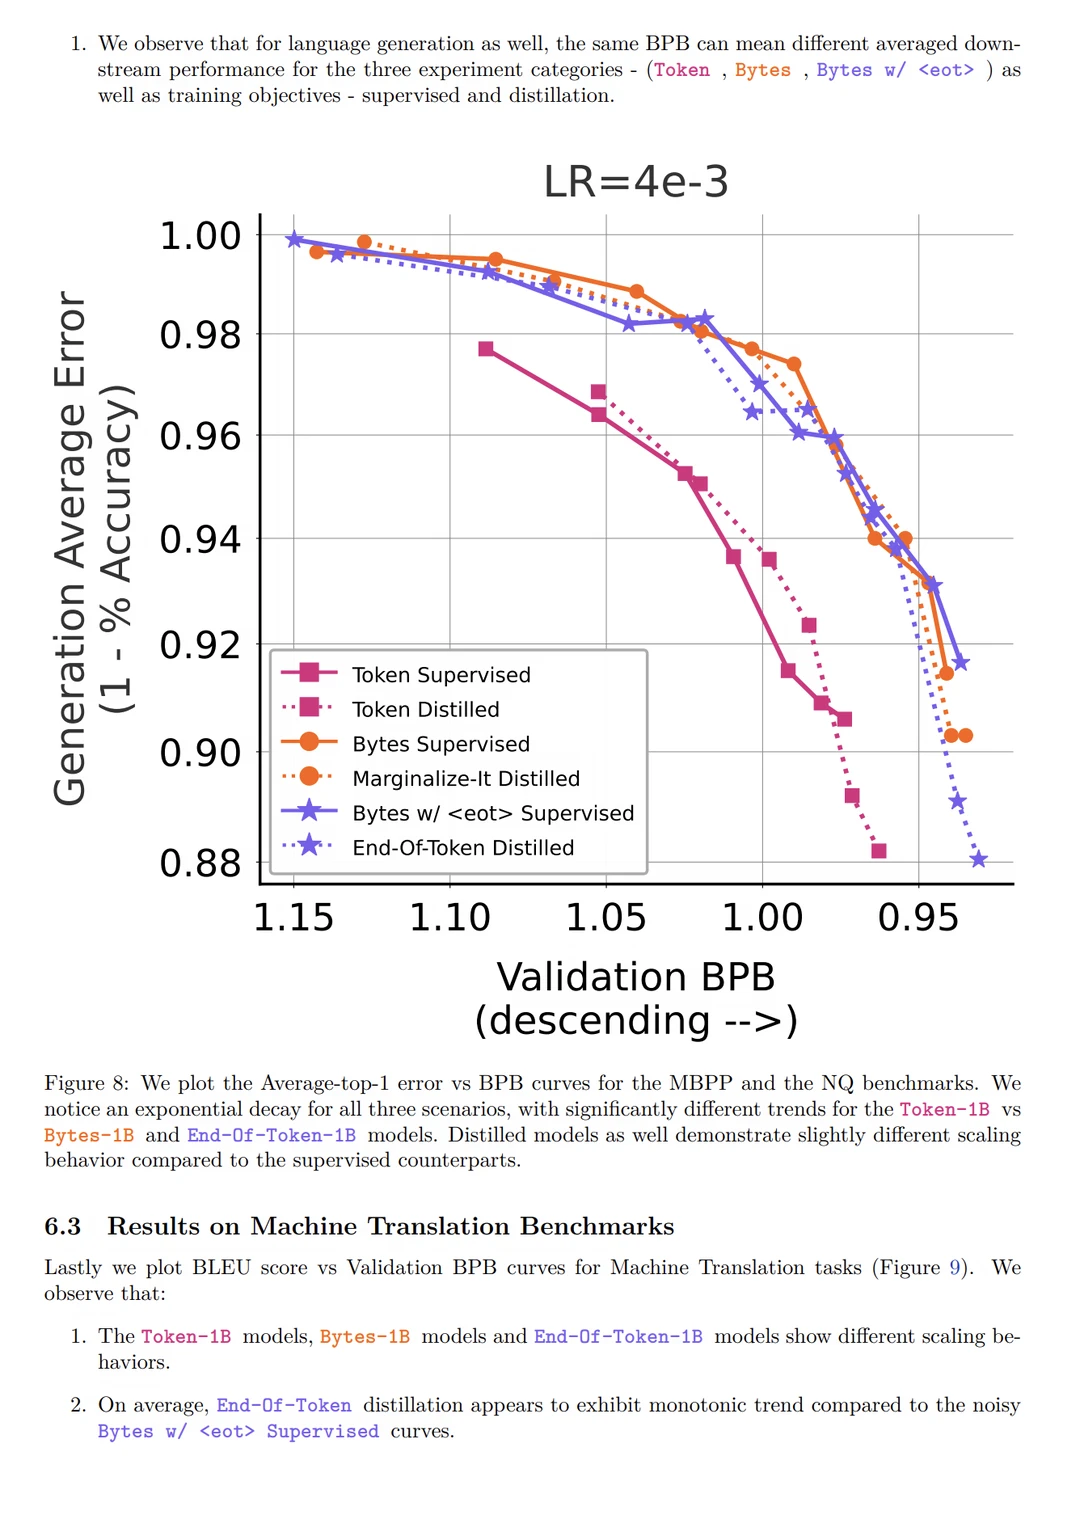
他们让约 10 亿层参数的 token / byte 模型在最多 1 万亿字节数据上过训练,并测了 ARC、HellaSwag、PIQA、MBPP、Natural Questions、Flores 等 8 项任务。
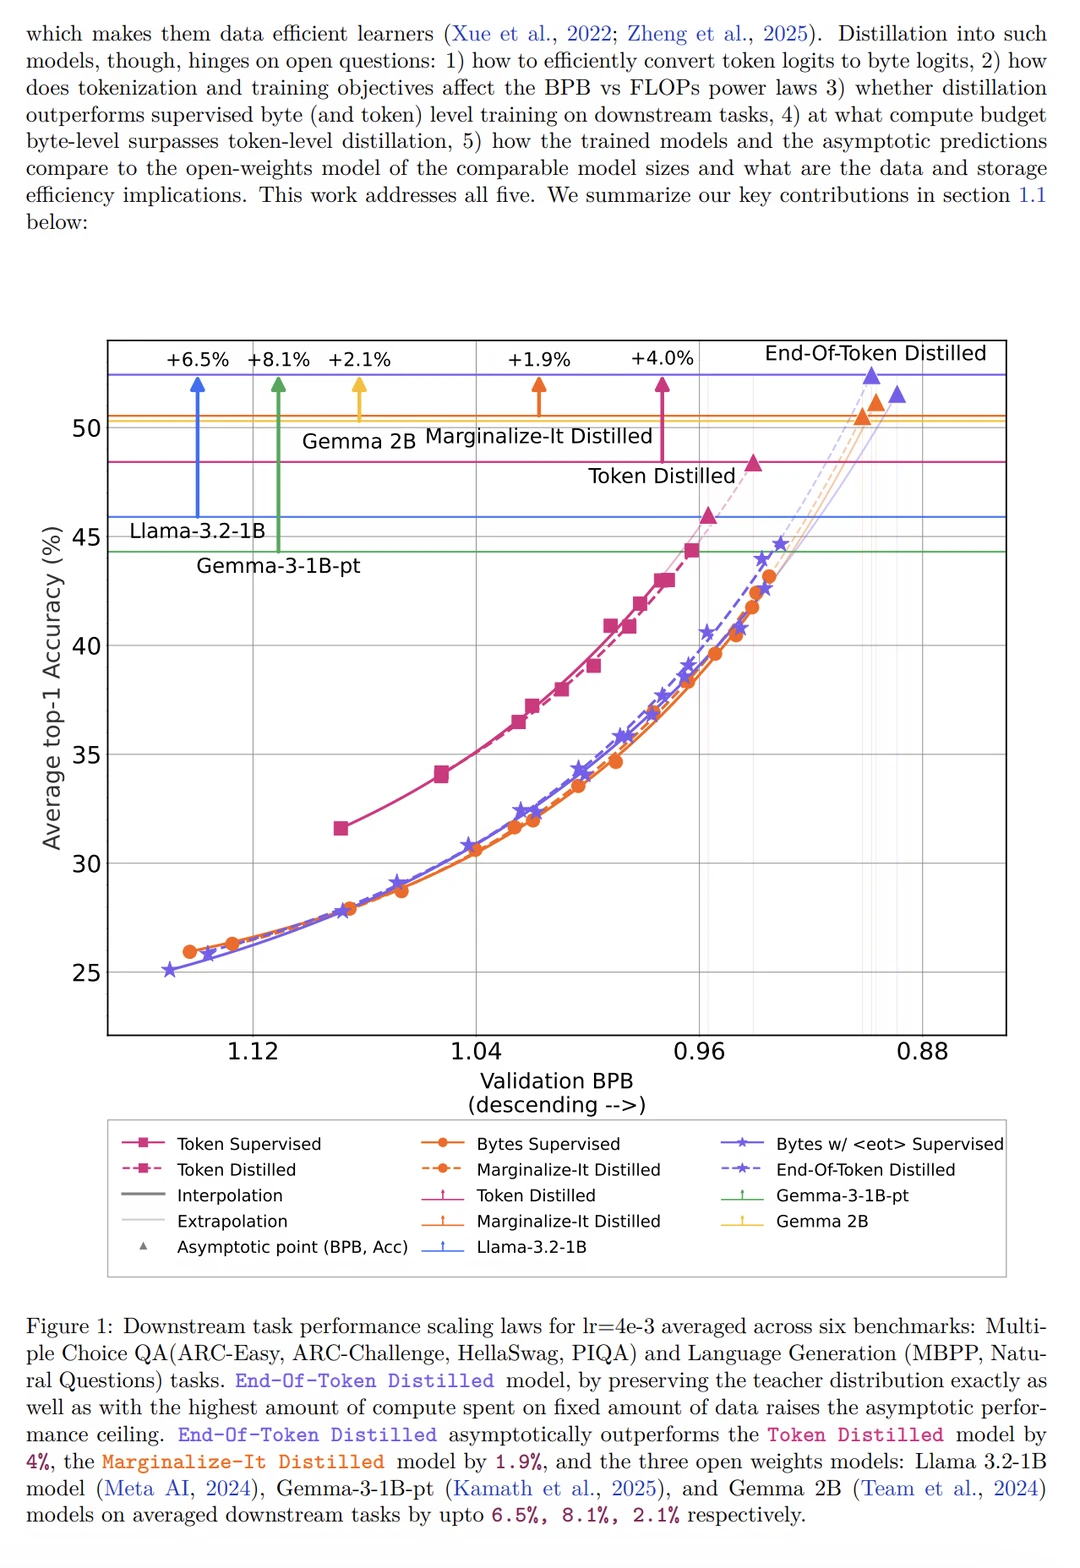
结论很有意思,低算力阶段 token 学生更强,但增长会较早变缓;byte 学生起步更差,却会随着算力继续提升。按其拟合的 scaling law,End-Of-Token 蒸馏的长期平均下游表现可比 token 蒸馏高最多 4%。
更值得工程团队关注的是离线蒸馏成本。
在论文设定下,它达到 token 蒸馏同等预测性能约只需六分之一的原始文本数据,logit 存储可降至约五分之一。
它不是“字节模型已全面替代 token”,而是提示当训练足够久、蒸馏数据与 logit 存储成为瓶颈时,分词器未必是小模型的最优接口。
推荐给做小模型预训练、离线蒸馏、tokenizer 与 scaling law 的研究者和工程师。论文给大家上传到附件啦~
#MetaFAIR #知识蒸馏 #ByteLevelModel #Tokenizer #ScalingLaw #小语言模型 #LLM训练