TileRT:把低延迟解码接进 vLLM 推理服务
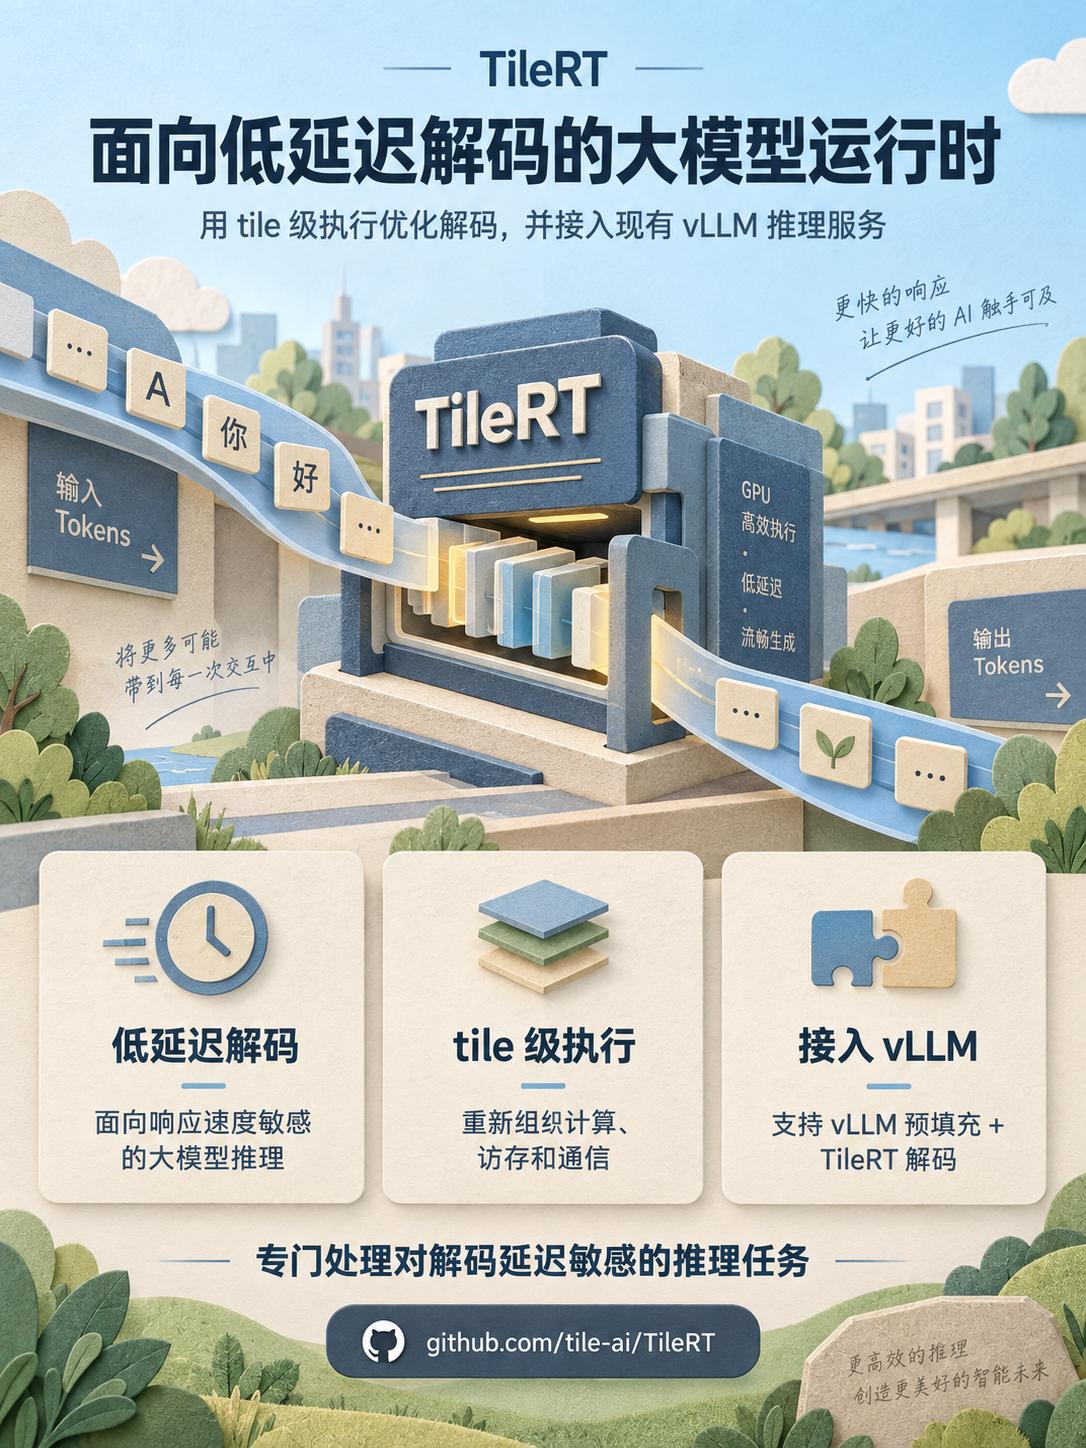
做大模型推理时,除了吞吐,响应速度也越来越重要。对 Agent、代码补全、实时交互这类场景,用户更直接感受到的是下一段内容多久出来。
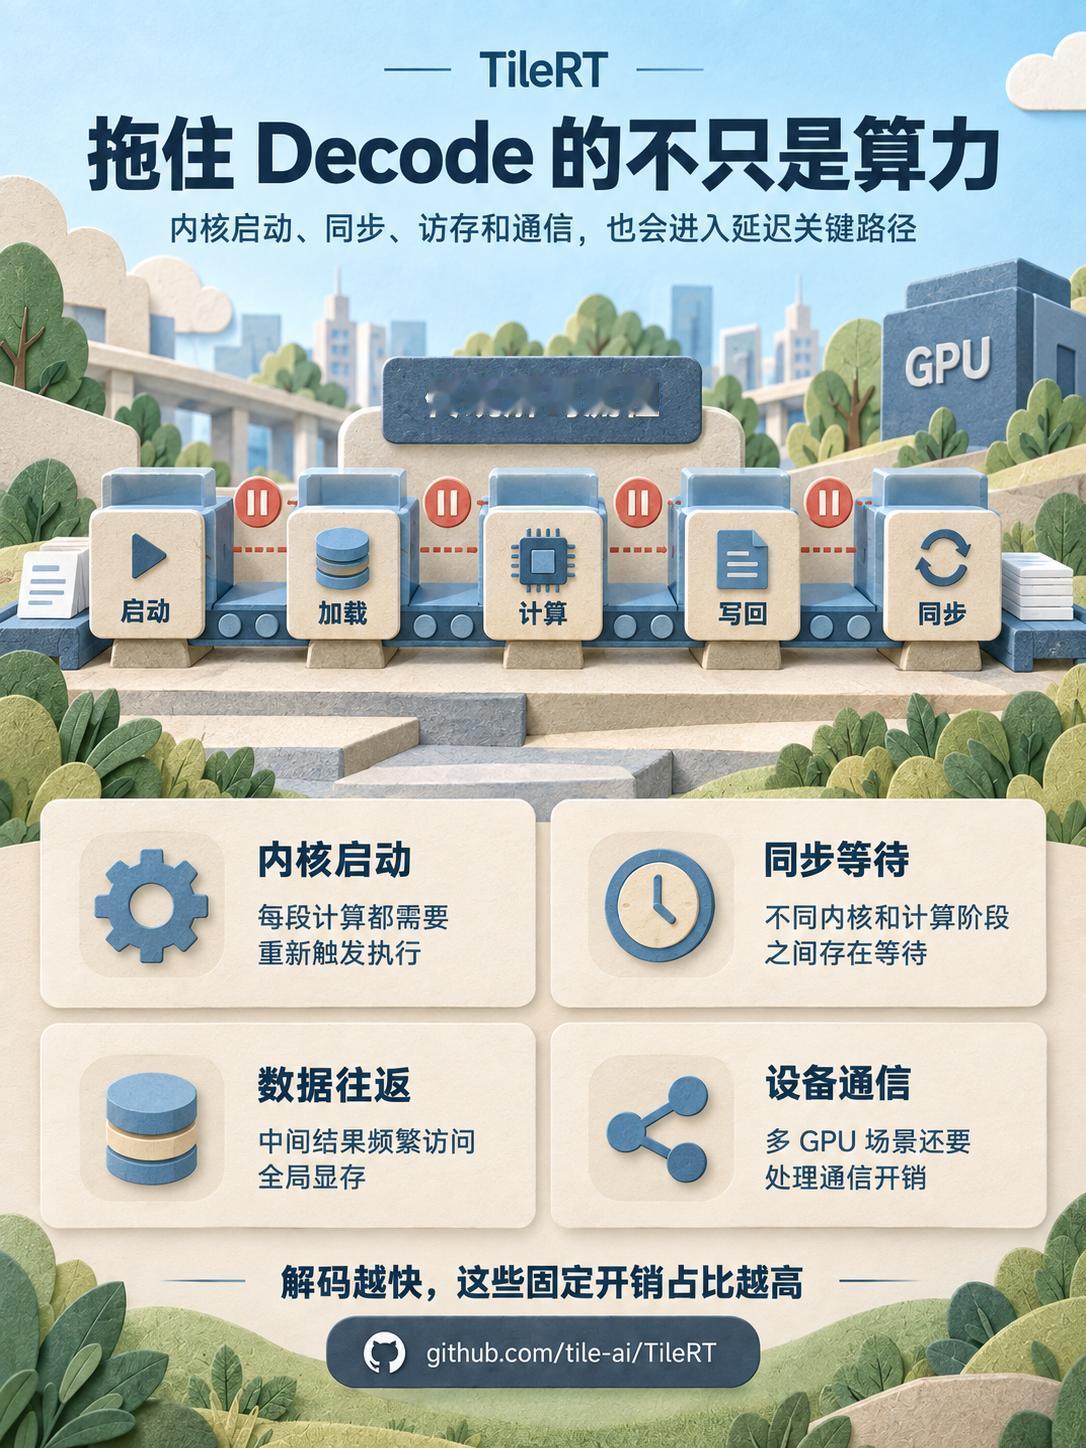
TileRT 就盯着这部分延迟。它是一个面向低延迟解码的大模型运行时,重点处理内核启动、同步、访存、设备通信等固定开销。随着单次解码越来越快,这些原本容易被计算时间掩盖的开销,也会逐渐进入延迟关键路径。
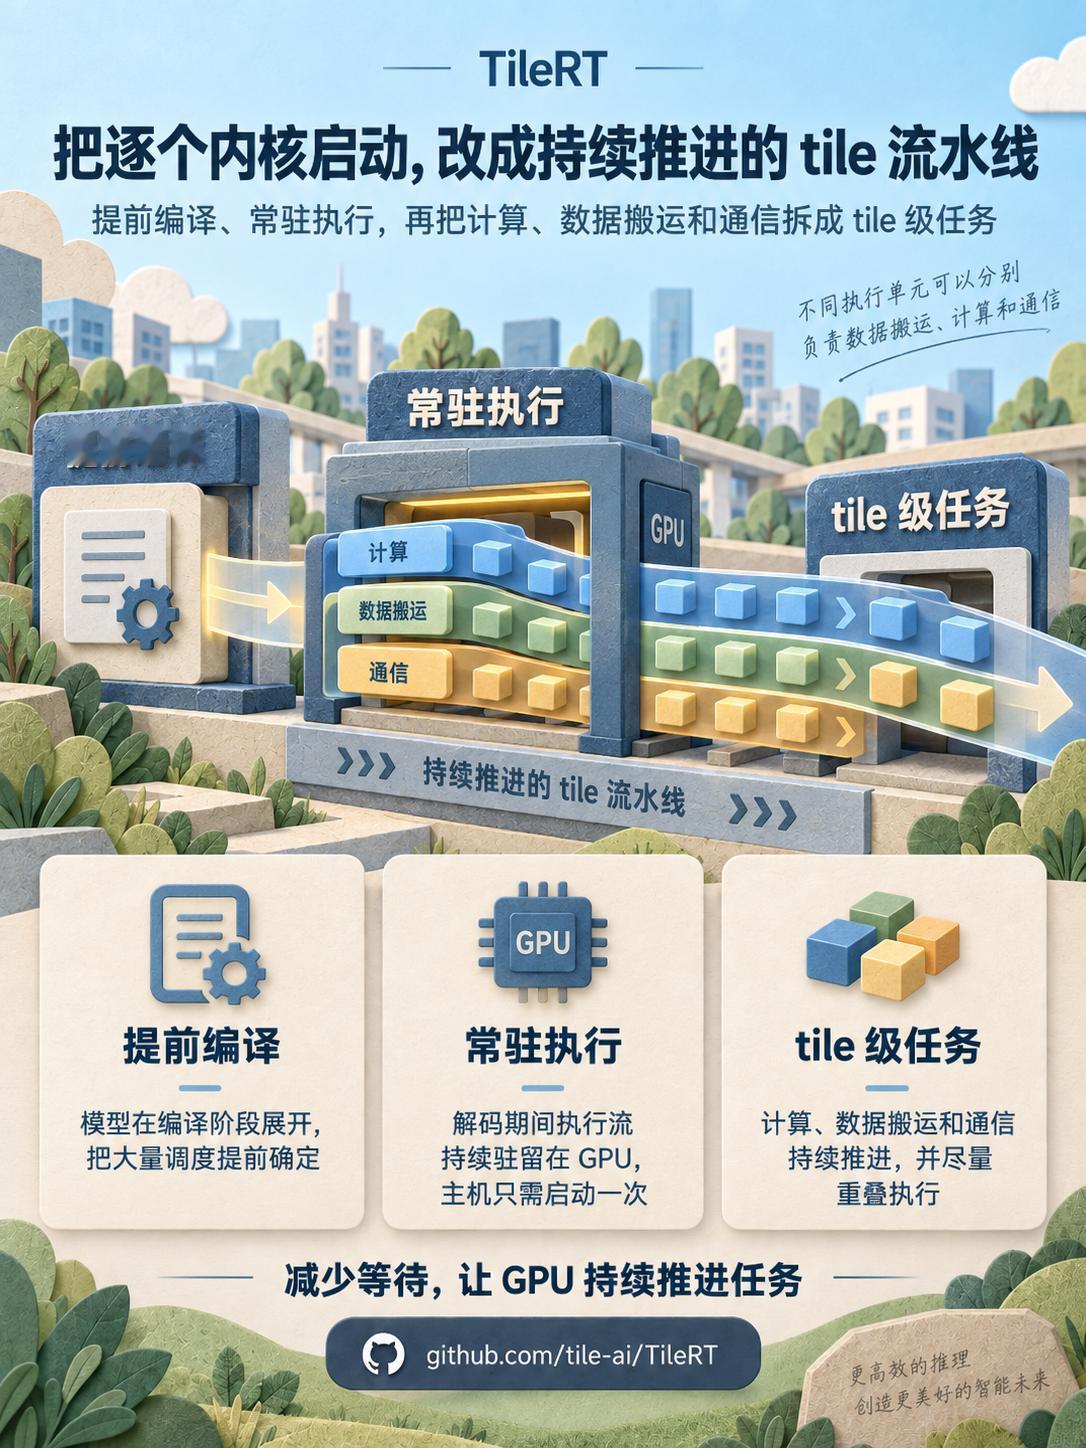
它的做法是从执行方式入手:在提前编译阶段展开模型,把大量调度提前确定;解码期间让执行流持续驻留在 GPU,再把计算、数据搬运和通信拆成 tile 级任务,让不同任务尽量重叠推进,减少等待。
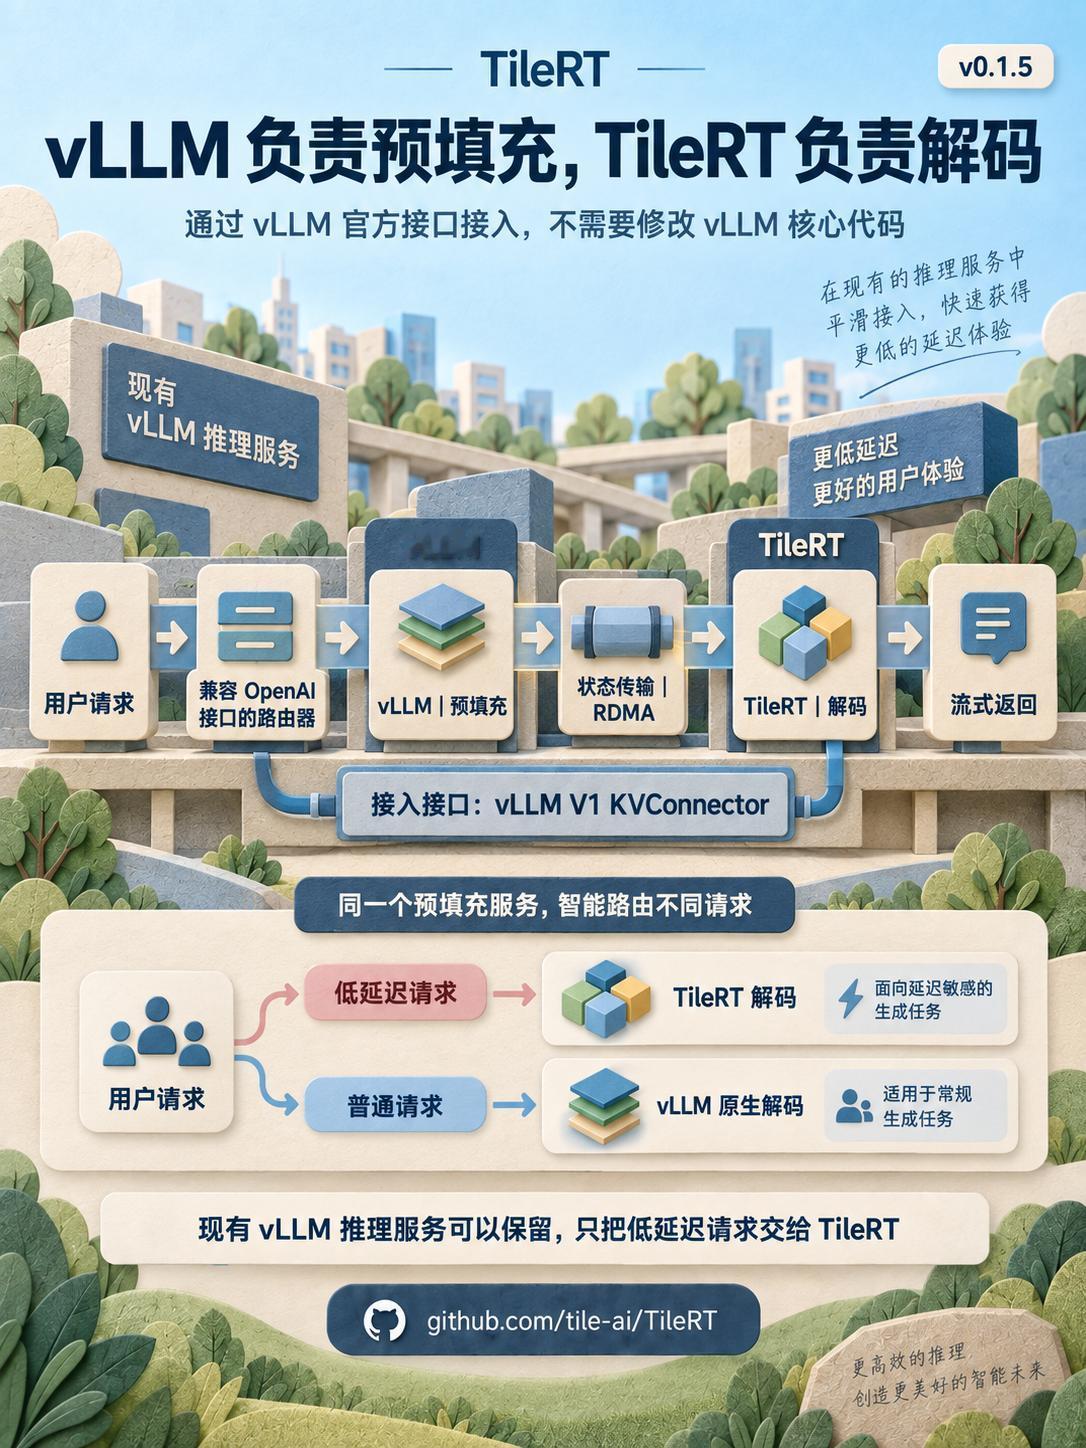
当前版本还加入了 vLLM 预填充 + TileRT 解码的 PD 分离方案。TileRT 通过 vLLM V1 的 KVConnector 接入,不需要修改 vLLM 核心代码。已有 vLLM 推理服务可以继续负责预填充和上层服务,低延迟请求交给 TileRT 解码,普通流量仍可继续走 vLLM 原生解码路径。
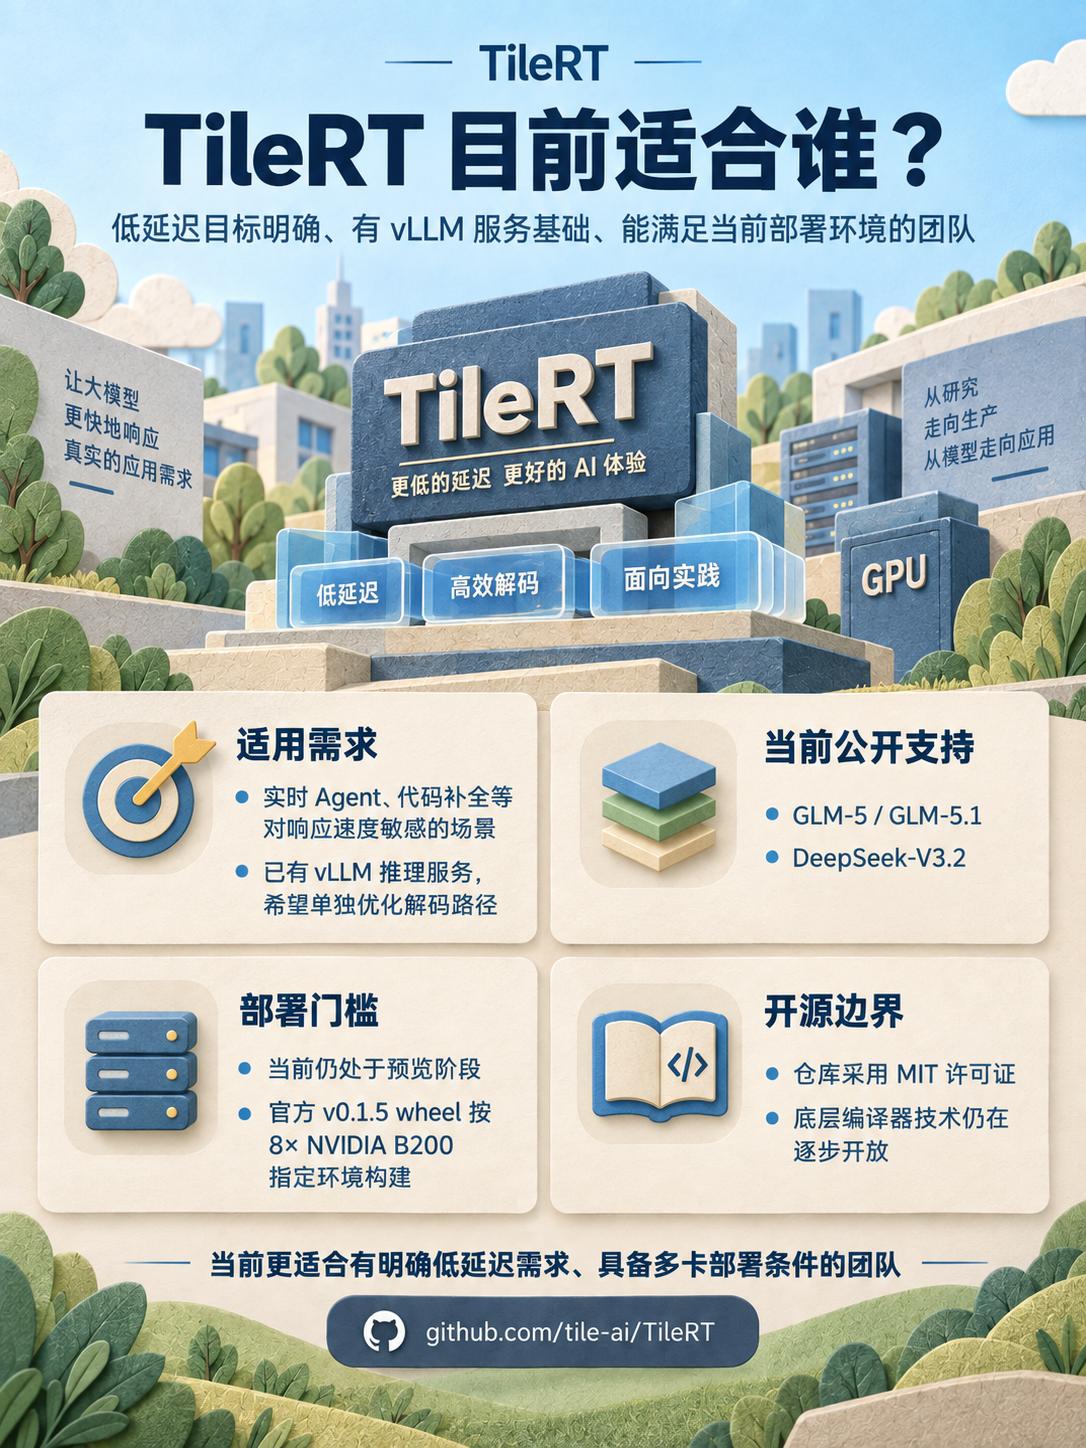
目前 TileRT 仍处于预览阶段,官方 v0.1.5 wheel 的构建环境也比较严格,包括 8× NVIDIA B200、Linux x86_64、Python 3.12 等。所以它目前更适合已经有大模型推理服务、对单请求响应速度有明确要求,并具备多卡部署条件的团队评估。
TileRT 大模型推理 推理加速 低延迟推理 vLLM GPU Agent AI基础设施竞争的核心指标是什么