RLT 发布,把循环带回 Transformer?
600 多个 star,数十个 fork。这个仓库,这两天在海外引发剧烈讨论。 [看]
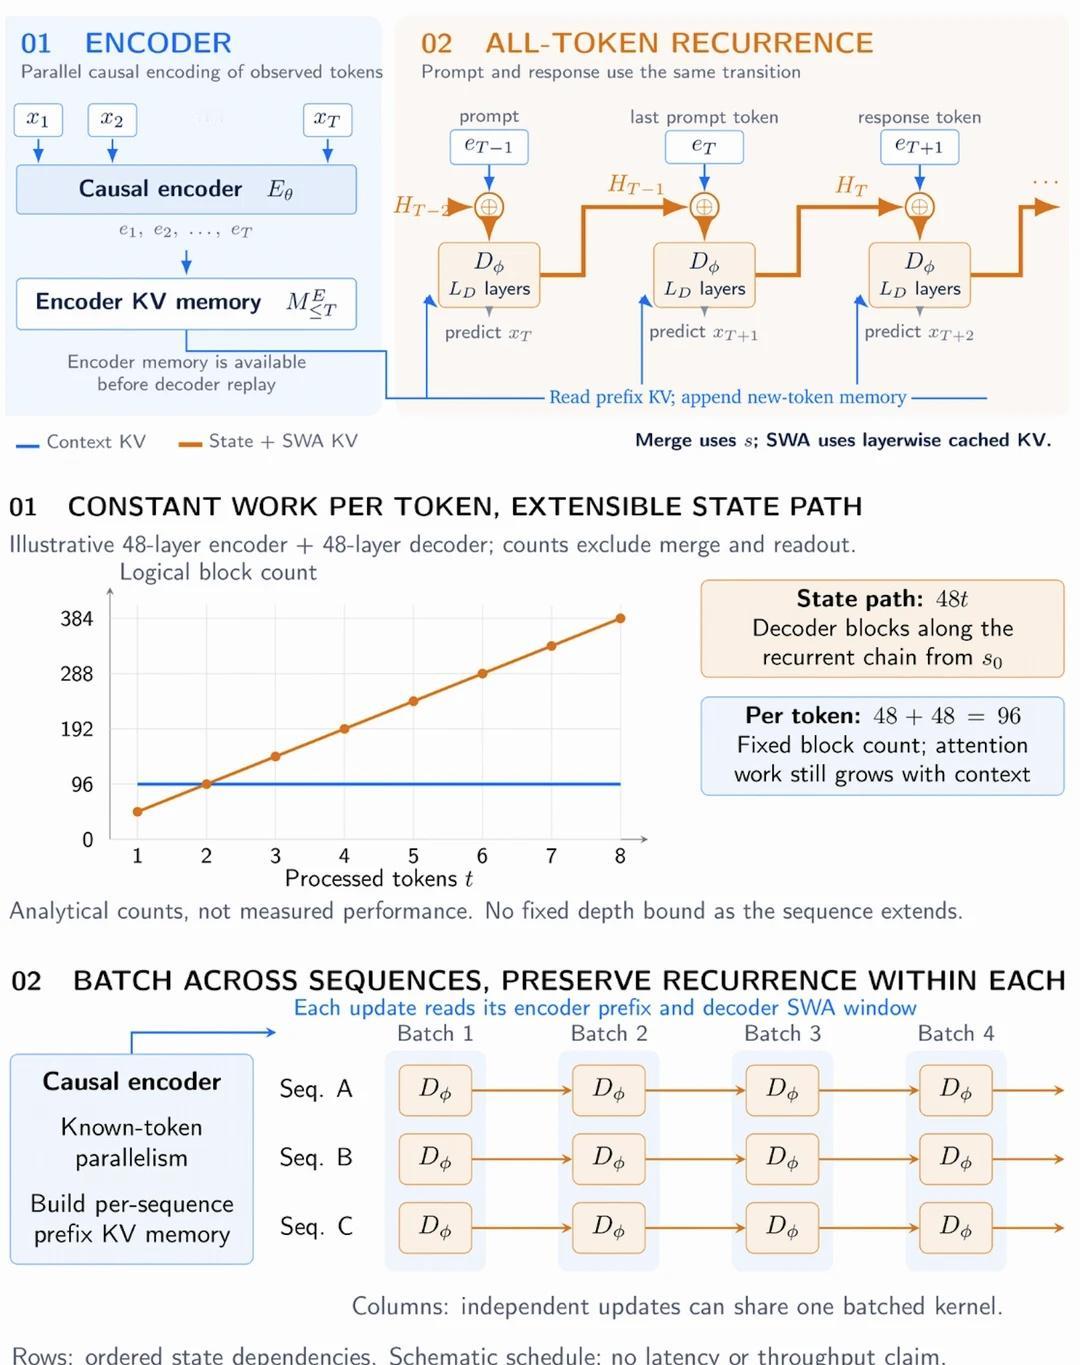
Recurrent Looped Transformer 把每个 token 的末层输出接回下一个 token,中间不做并行近似,这条循环就是唯一的状态转移,预训练、SFT、采样和 RL 回放全走它(图1)。
Encoder 并行编码已观察的 token 产出全局 KV,decoder 每层先读自己的滑窗 KV,再交叉读 encoder 记忆,末层输出经门控并入下一个 token 的编码,两者跨过 prompt 边界都不重置。参考配置 48 加 48 层,同层权重共享,每个 token 固定跑 96 个逻辑块,t 个 token 之后这条链累计穿过 48t 个 decoder 块。
prompt 的每个 token 都要逐个过 decoder,没有并行 prefill,训练还要沿整条序列做完整 BPTT。作者承认这拉低硬件利用率,不宣称任何 prefill 加速,能并行的只剩跨序列成批。 sampler 保留采样当时的行为概率,trainer 在每次权重更新后从序列起点重建 encoder KV、循环输出和全部滑窗缓存,detach 其中任一路都被定义为梯度近似。
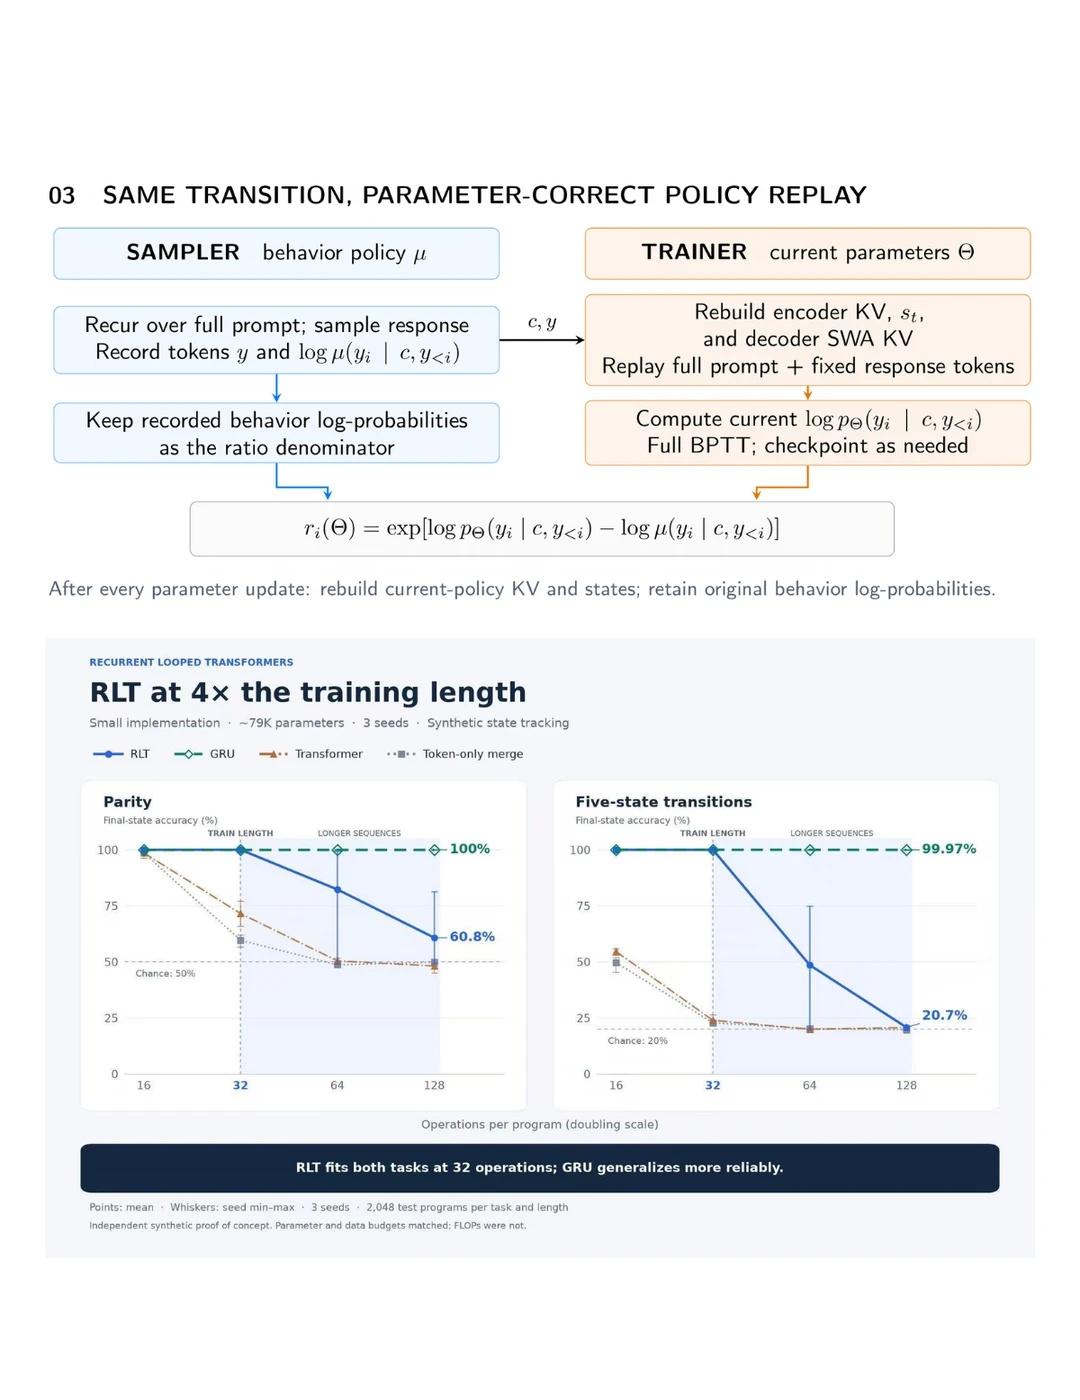
实验在仓库 README。79K 参数的合成状态跟踪,训练 32 步外推到 128 步时,parity 任务 RLT 60.8%,Transformer 约 48%,五状态转移 RLT 20.7%,随机水平 20%,同预算的 GRU 两项都接近满分(图2)。
48t 的深度没兑现成泛化,四倍训练长度处掉回随机,被 GRU 压住,附录 B 中,归一化约束不住这些 Jacobian 连乘,梯度能不能稳定穿回去同样没有证据。报告把这些都列成待验证目标。期待有人把它训到几十亿参数,那时候才知道这条越拉越长的计算路径通不通向 latent reasoning。[微笑]
大模型 论文 论文解读 Loop AI 人工智能发展