开源版 ElevenLabs,模型还能自己换
声音克隆的开源项目不少,VoiceStudio 会更像是一个语音工作台。
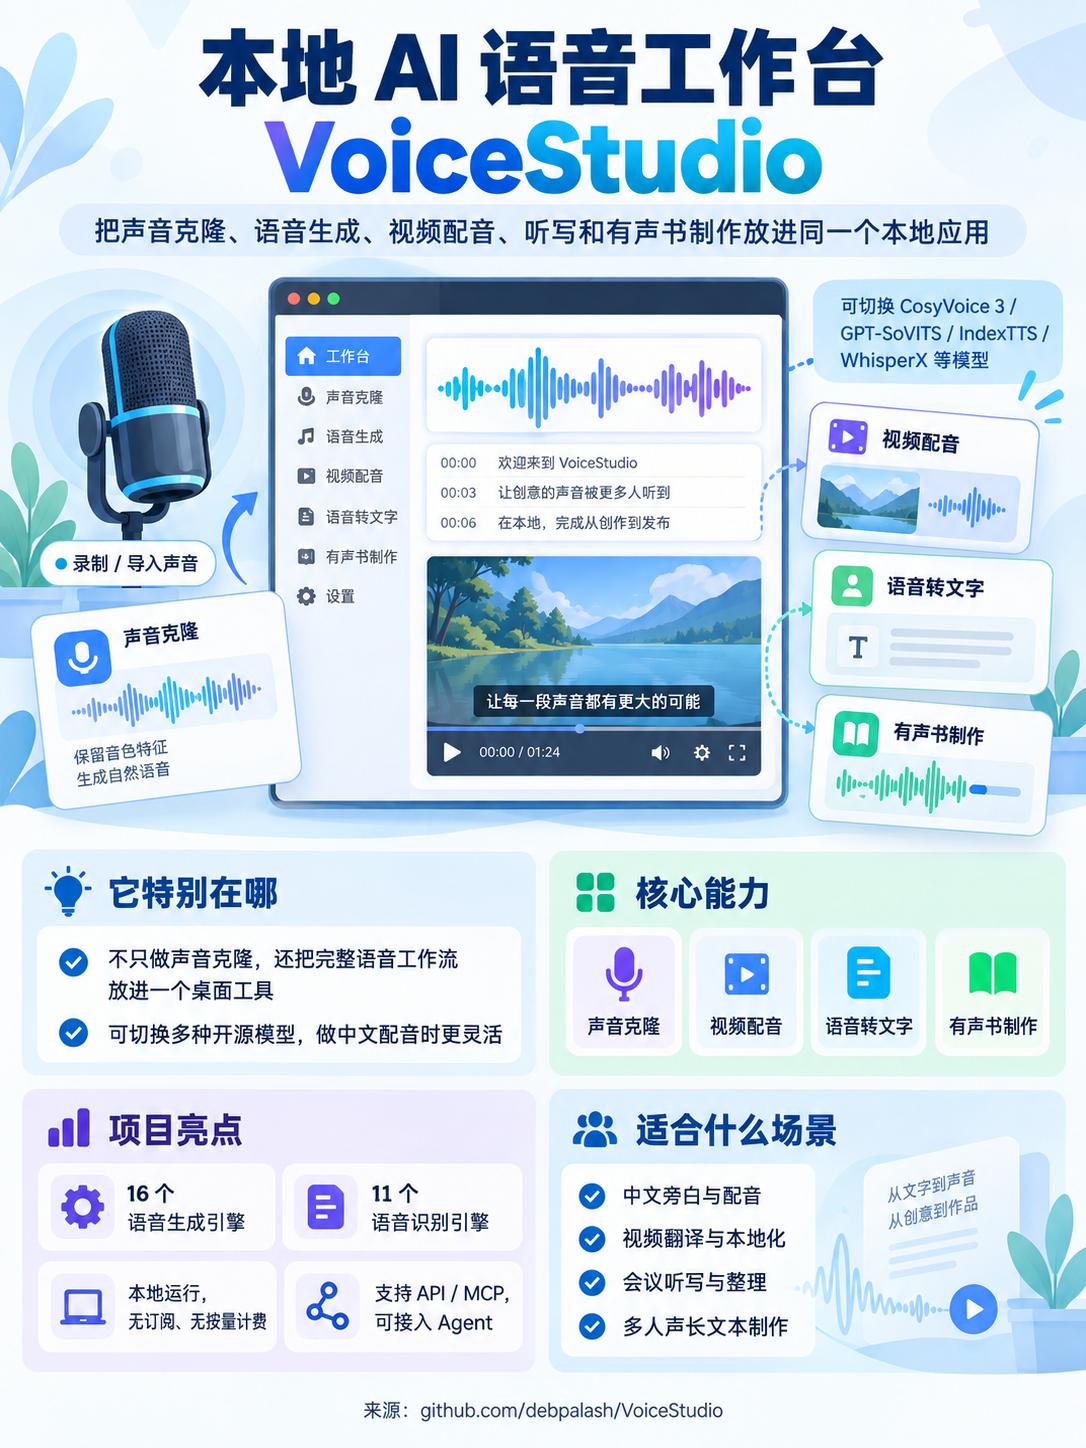
它把声音克隆、语音生成、视频配音、语音转文字和有声书制作放进了同一个本地桌面应用。你只要导入一段参考音频,它就能克隆声音。此外,它还能直接生成语音、给视频配音,或者把长文本做成多人声的内容。
和 ElevenLabs 单一模型不同,VoiceStudio 支持在多种语音模型间进行切换。目前,项目已经接入 16 个语音生成引擎和 11 个语音识别引擎,包括 CosyVoice 3、GPT-SoVITS、IndexTTS、WhisperX 等。使用语音模型时,你可以根据语言、音色等等角度来选择最合适的那个模型。对于中文内容,VoiceStudio 也提供了更多模型选项,比如 CosyVoice 3、GPT-SoVITS 和 IndexTTS 等。
除了生成一段单独的语音,它还把不少后续工作整合到了一起。比如给视频配音,会先识别原视频中的语音,再处理字幕和说话人,最后选择对应的声线重新生成音频;做有声书时,能为不同的角色分配对应的声音,再按章节或段落生成长篇语音内容。项目还支持批量生成,可以一次处理多段音频或视频。
VoiceStudio 还支持本地运行,可以把声音、项目和生成结果保存在自己的设备上。因为本地使用不需要账号、API Key 和订阅,自然也不用按量付费。
除了桌面应用,它还提供了本地 API、兼容 OpenAI Audio API 的接口以及 MCP Server,你可以接入自己的应用或 Agent 中。
如果你只是偶尔做一次声音克隆,单独的语音模型就够用了。VoiceStudio 会比较适合需要经常处理配音、转录、视频和长音频的创作者,以及想把本地语音能力接入自己应用的开发者。
开源项目 AI语音 声音克隆 VoiceStudio 语音生成