和做 AI 的朋友聊到一件怪事,越想越离谱:美国人一边骂中国公司 “抄” 他们的大模型,一边眼睁睁看着人家用中国的电、中国的芯片,把美国大模型蒸馏完,还开源给全世界,这算什么操作?
眼看中美 AI 峰会就要开了,圈内聊得最热的,却是美国头部 AI 企业 “A 社” 刚发的 9 月安全报告,直接把国内排名靠前的中国 AI 大模型全点了名,一口咬定它们都在 “蒸馏” 美国模型。
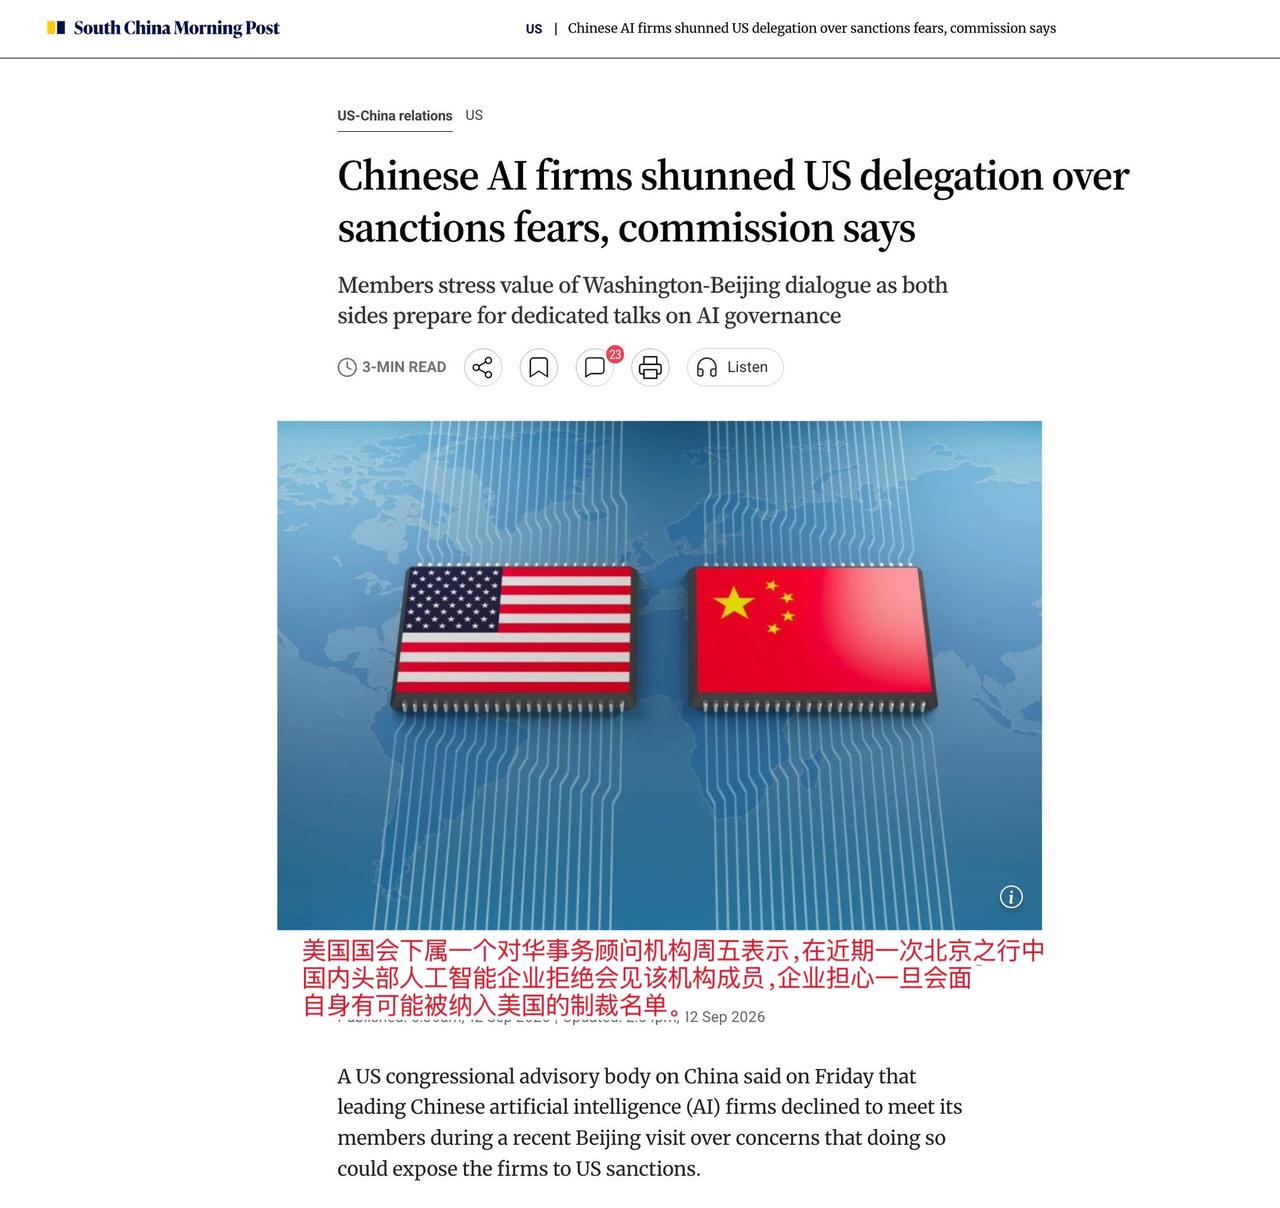
准确说,不是企业报告,是美国官方下场了。9 月 8 日,美国国家安全局、联邦调查局、网络安全局三家联合发布公告,点名六家中国头部 AI 企业,指控它们开展 “工业规模” 的模型蒸馏,窃取美国大模型的能力。
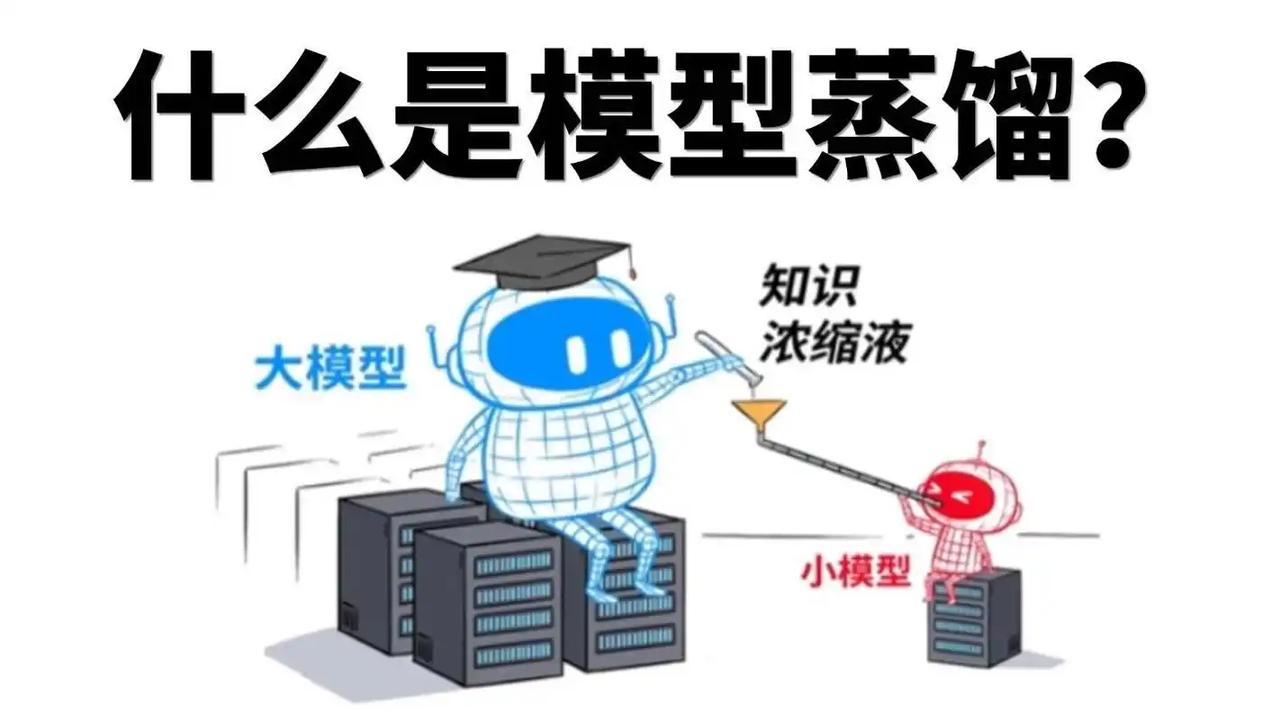
先解释一下什么是模型蒸馏。简单说就是用大模型的输出数据,来训练更小的模型,让小模型也能获得接近大模型的能力。这是全球 AI 行业通用的基础技术,从诞生那天起,所有公司都在用。
美国企业自己也没少用。开源社区的模型,大多都是靠蒸馏闭源模型提升性能的,美国的初创公司这么干的比比皆是。之前从来没人说这是偷,直到中国企业也这么干了,就突然成了违法行为。
公告里说得煞有其事,说中国企业通过数百万次请求,提取了数十亿个词符,大幅缩短了研发周期,节省了成本。可这些说法,根本经不起推敲。
模型蒸馏只能学到表层的输出能力,学不到底层的预训练技术和架构。真正核心的训练方法、数据配比、对齐技巧,光靠蒸馏是拿不到的。中国大模型能追上来,靠的是自己的算力、数据和工程师,蒸馏最多就是个辅助手段。
美国之所以拿这个说事,时机选得特别巧。再过不久中美就要开 AI 峰会,美国先把帽子扣过来,把中国企业打成偷窃者,到了谈判桌上,就能拿着这个当筹码,逼中国让步。
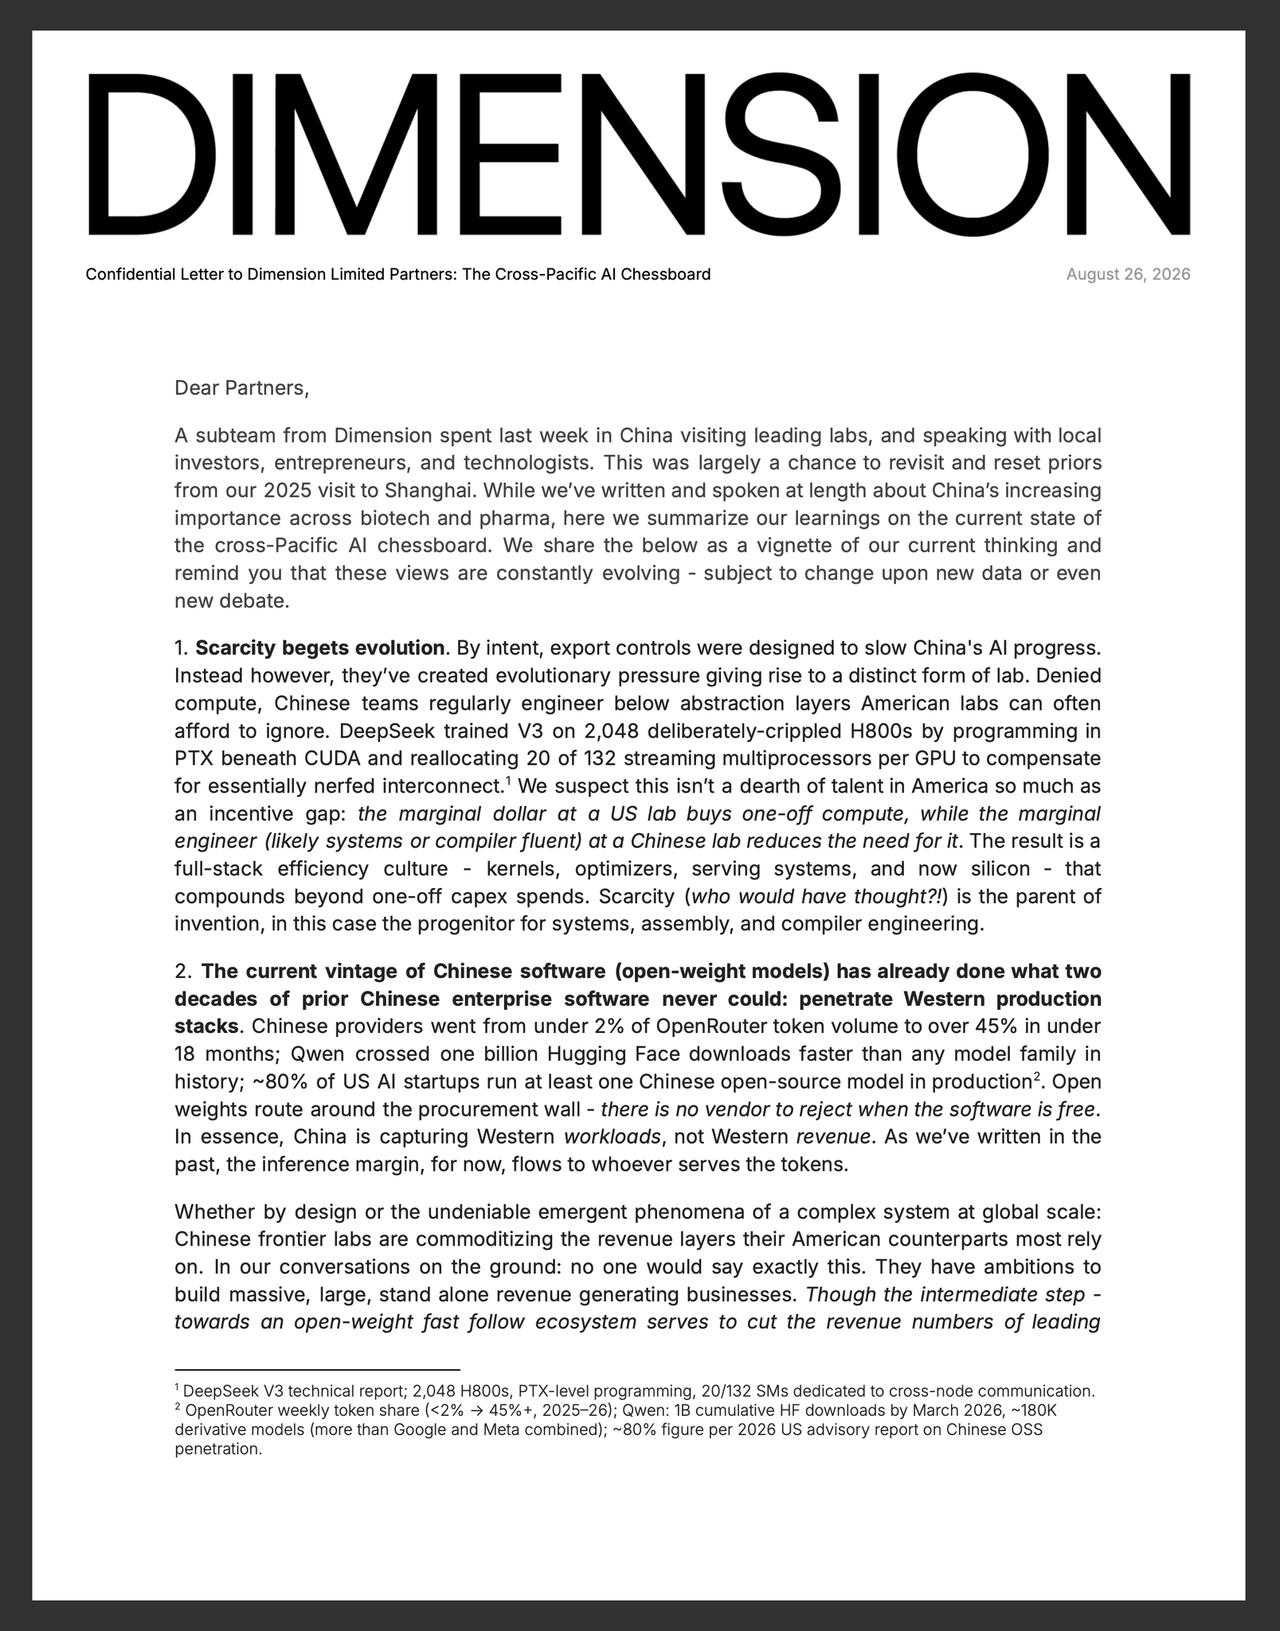
更深层的原因,是中国的开源大模型进步太快了。现在中国的开源模型,性能已经非常接近美国的闭源模型,而且免费开放,全世界开发者都在用。美国靠闭源垄断 AI 技术的路子,眼看就要走不通了。
所以美国要想办法打压。先是限制芯片出口,现在又拿蒸馏说事,本质上就是要给中国 AI 的发展制造障碍,尽量放慢追赶的速度,保住自己的领先地位。
更有意思的是同一周发生的另一件事。OpenAI 宣布用 AI 攻克了困扰数学界近百年的纳维 - 斯托克斯方程难题,结果转头就被数学家爆料,用了人家未发表的论文草稿,等于偷了数学家的成果。
同样是拿别人的东西训练自己的模型,美国企业干就是技术突破,中国企业干就是工业偷窃。这套双重标准,玩得简直不要太熟练。
中国商务部已经明确回应,美方的指控于事无凭、于法无据,是典型的科技霸权。蒸馏是行业通用技术,美方自己也在用,现在拿这个指责中国,就是把技术问题政治化。
这件事最核心的矛盾,其实是规则之争。谁来定义 AI 领域什么是合法,什么是侵权,什么是偷窃。美国想自己说了算,按照自己的利益制定规则,让全世界都遵守。
可现在的 AI 行业,早就不是美国一家独大了。中国有完整的产业链,有庞大的市场,有顶尖的工程师,已经有了平等对话的资格。美国想靠扣帽子、搞制裁就挡住中国 AI 的发展,根本不现实。
退一步说,就算美国真的禁了蒸馏,中国 AI 也不会停下脚步。反而会倒逼企业走完全自主的技术路线,从底层架构到训练方法全部自研,到时候差距只会缩得更快。
历史已经证明,每次美国封锁什么,中国就能把什么搞出来。当年封锁航天,我们有了空间站;当年封锁芯片,我们加速了国产化。现在封锁 AI,结果也不会有什么不同。
美国与其天天想着怎么打压对手,不如好好想想怎么提升自己的竞争力。靠垄断和霸权维持的优势,从来都长久不了。真正的技术领先,得靠公平竞争赢来的才算数。