OpenAI昨天公开了一份挺有意思的内部数据,我看完以后反而发现,我们很多人使用Codex的方法可能一开始就错了。
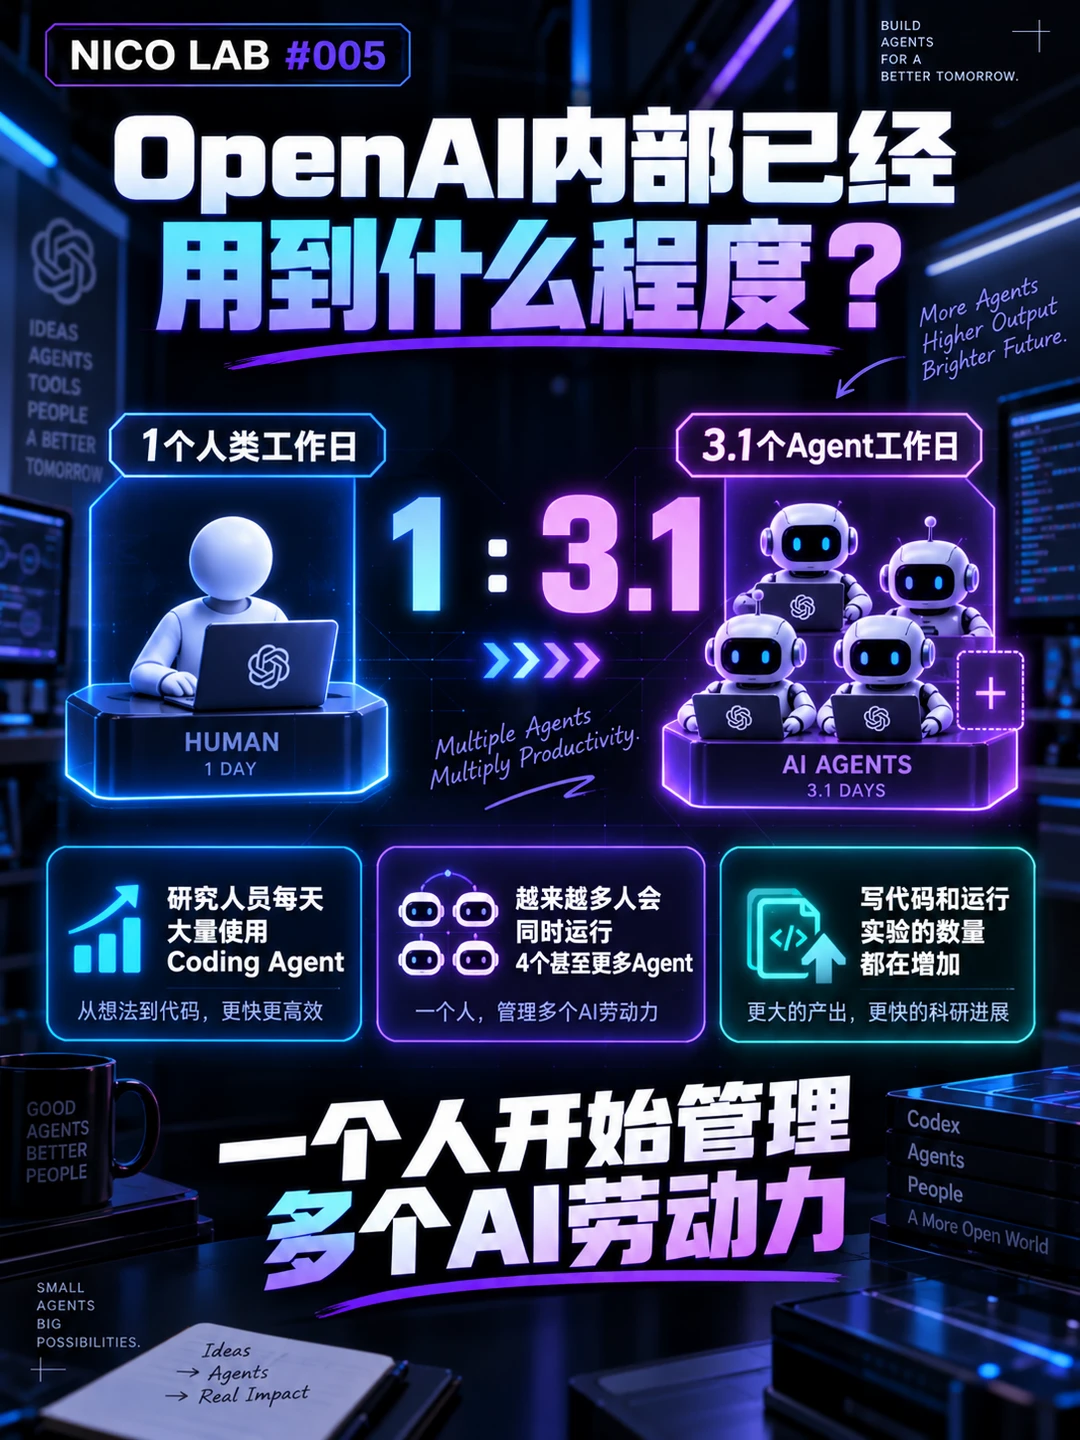
到今年8月中旬,OpenAI研究团队已经大量把Coding Agent放进日常工作。按照官方换算,他们现在每1个人类工作日,对应大约3.1个Agent工作日,而且越来越多研究人员会同时跑多个Agent。
这和很多普通用户的使用方式完全不一样。
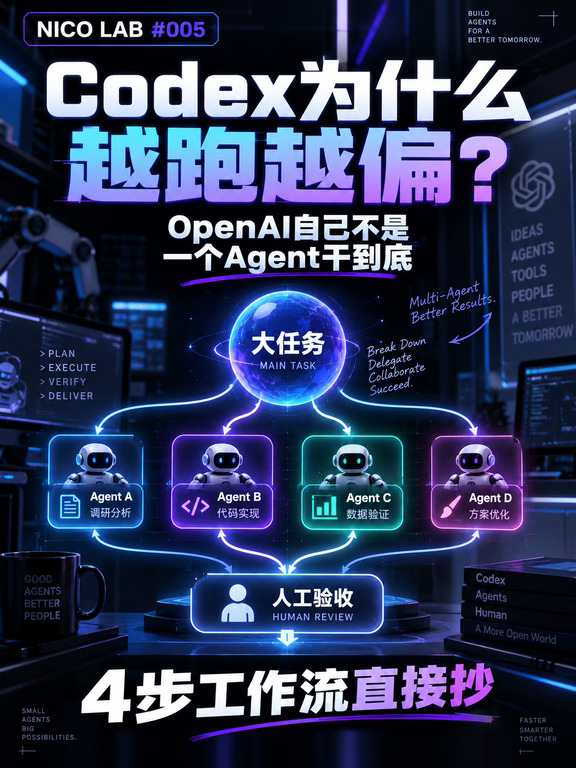
我们经常是把一个特别大的需求直接扔进去:“帮我把这个项目全部优化好。”然后让Codex自己跑一两个小时,回来以后发现它可能修改了很多东西,但真正想解决的问题反而没处理好。
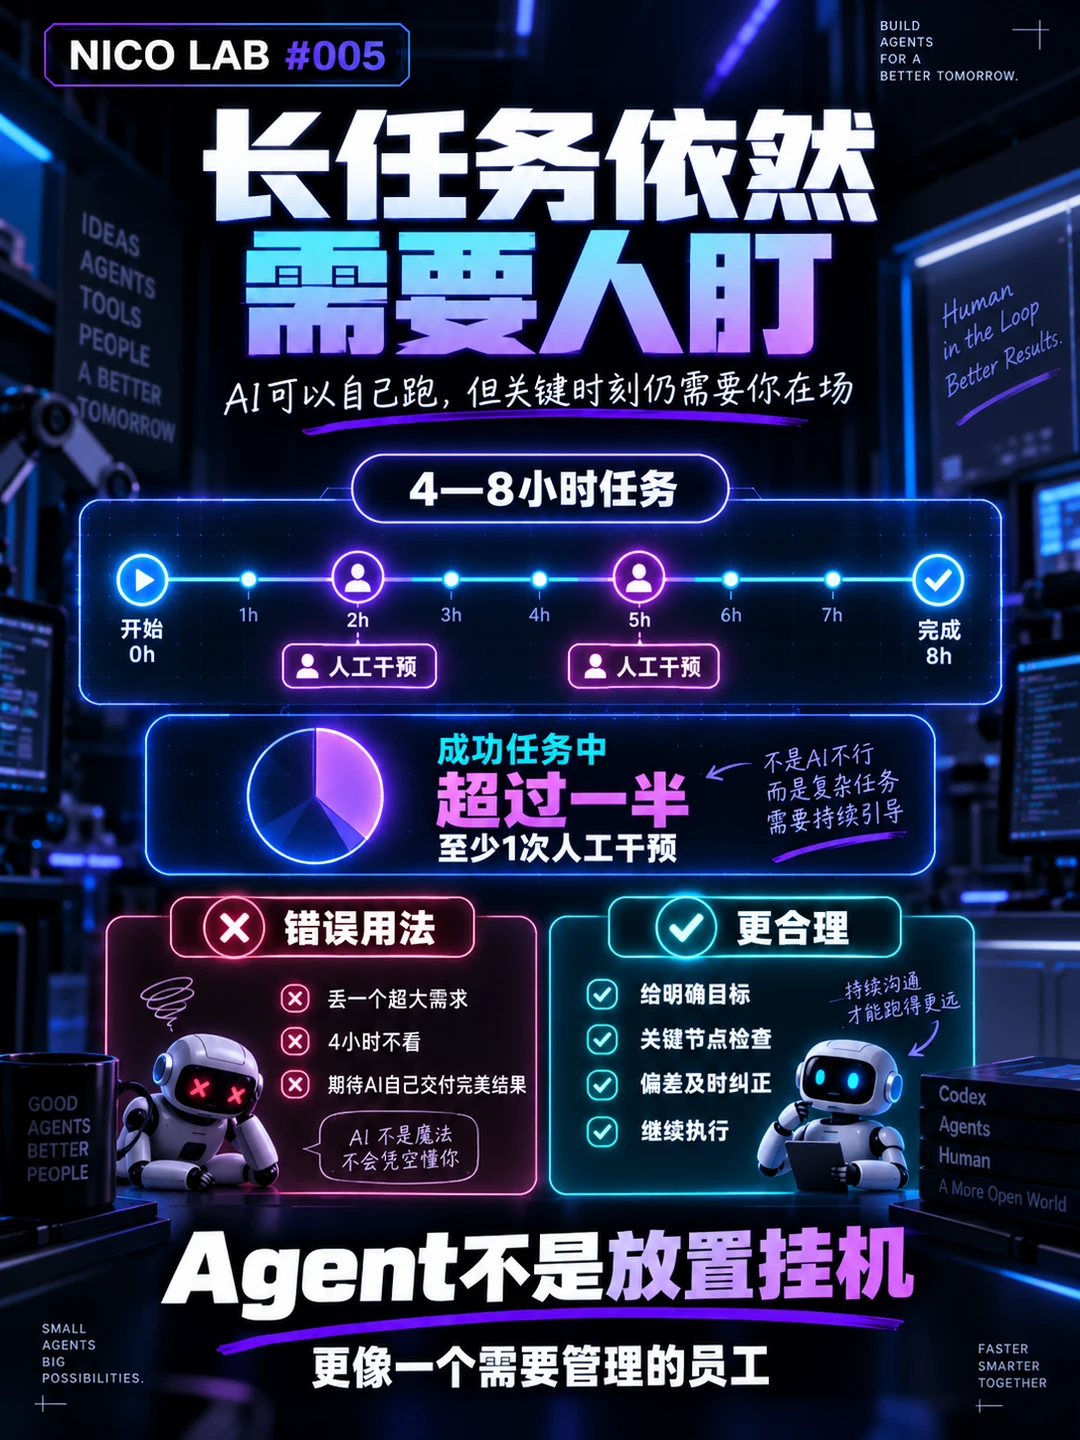
OpenAI自己公布的数据里有一个细节特别值得注意:对于最终成功完成的4—8小时长任务,超过一半至少发生过一次人工干预。也就是说,即使现在这些Agent已经很强,真正复杂的任务依然不是“开始以后人就可以完全离开”。
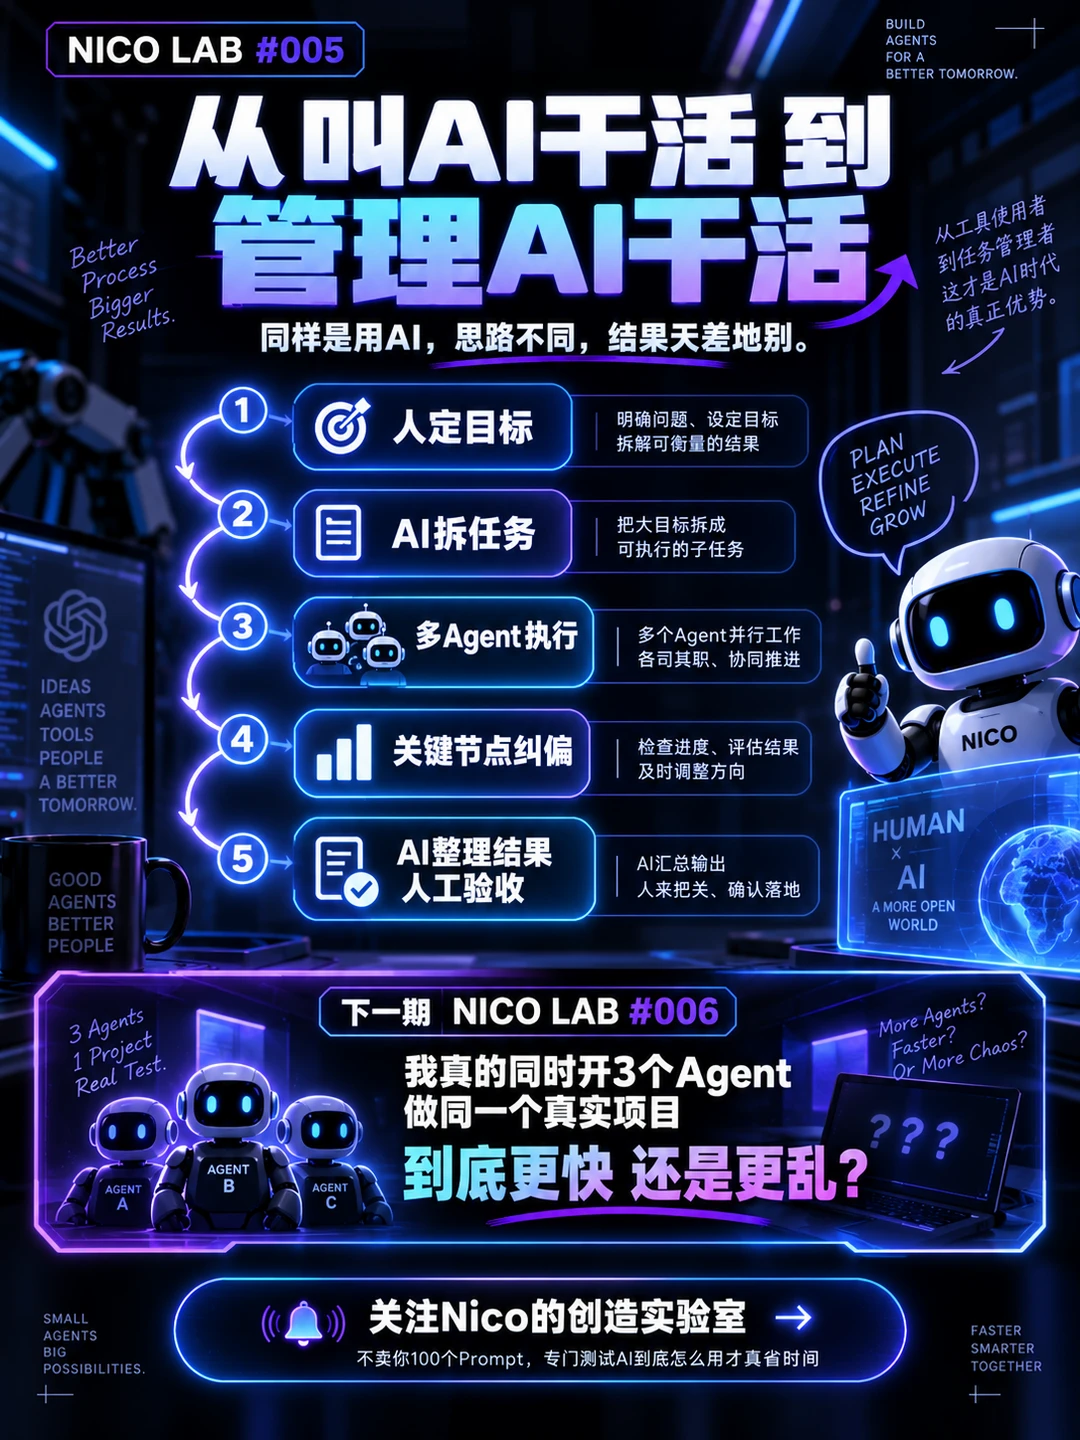
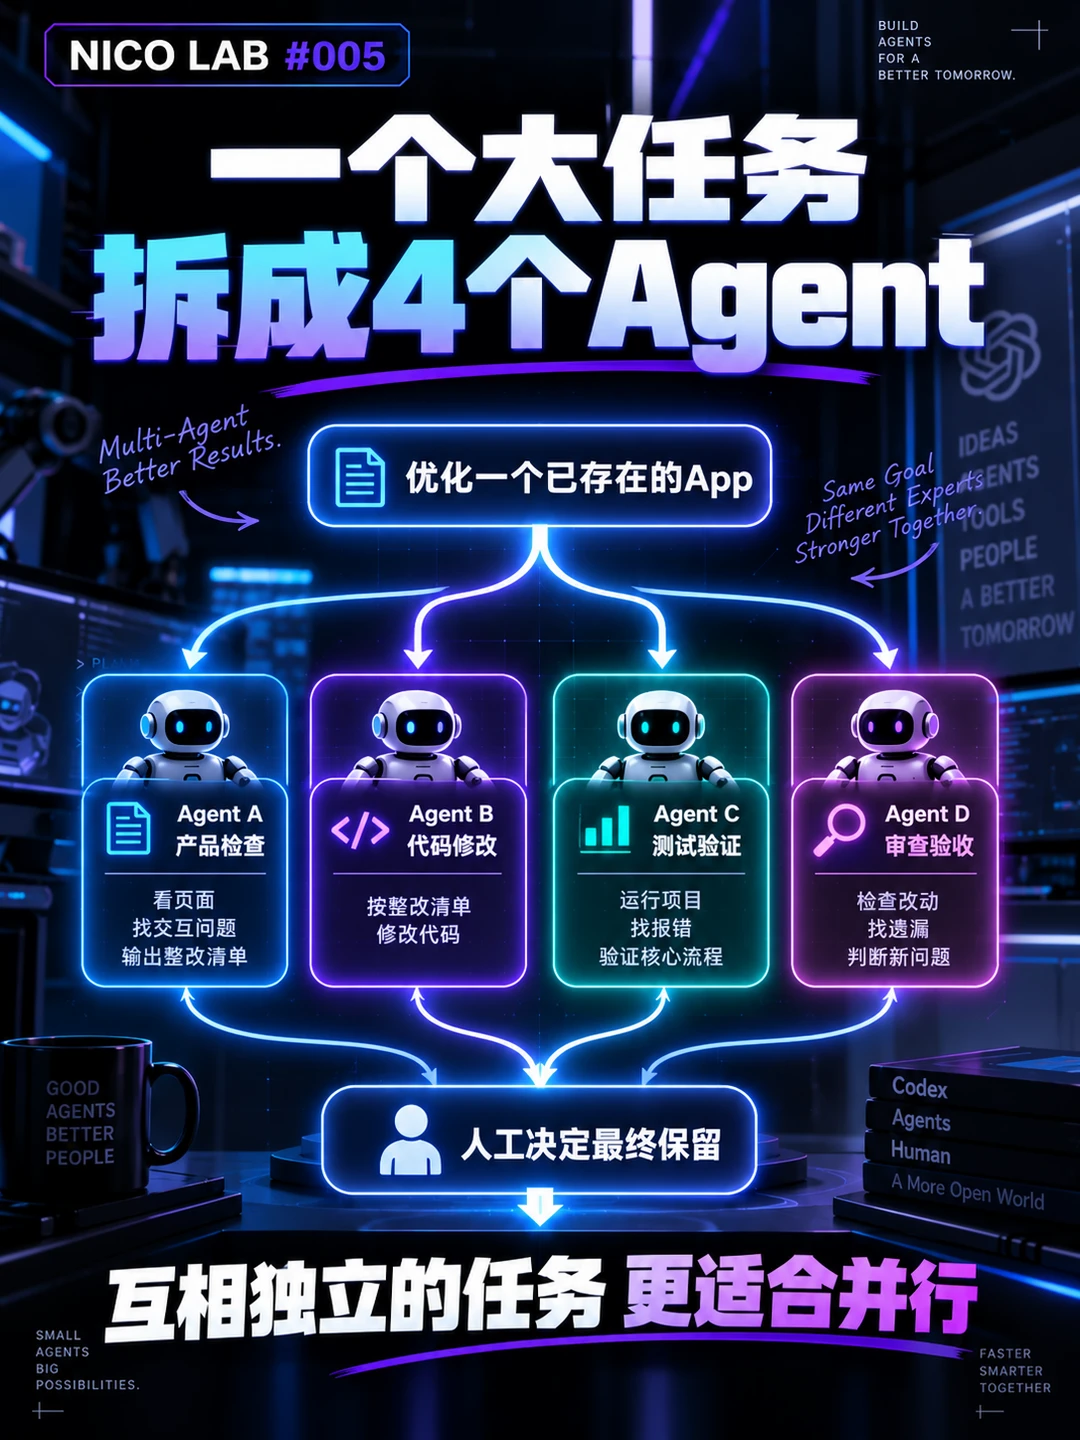
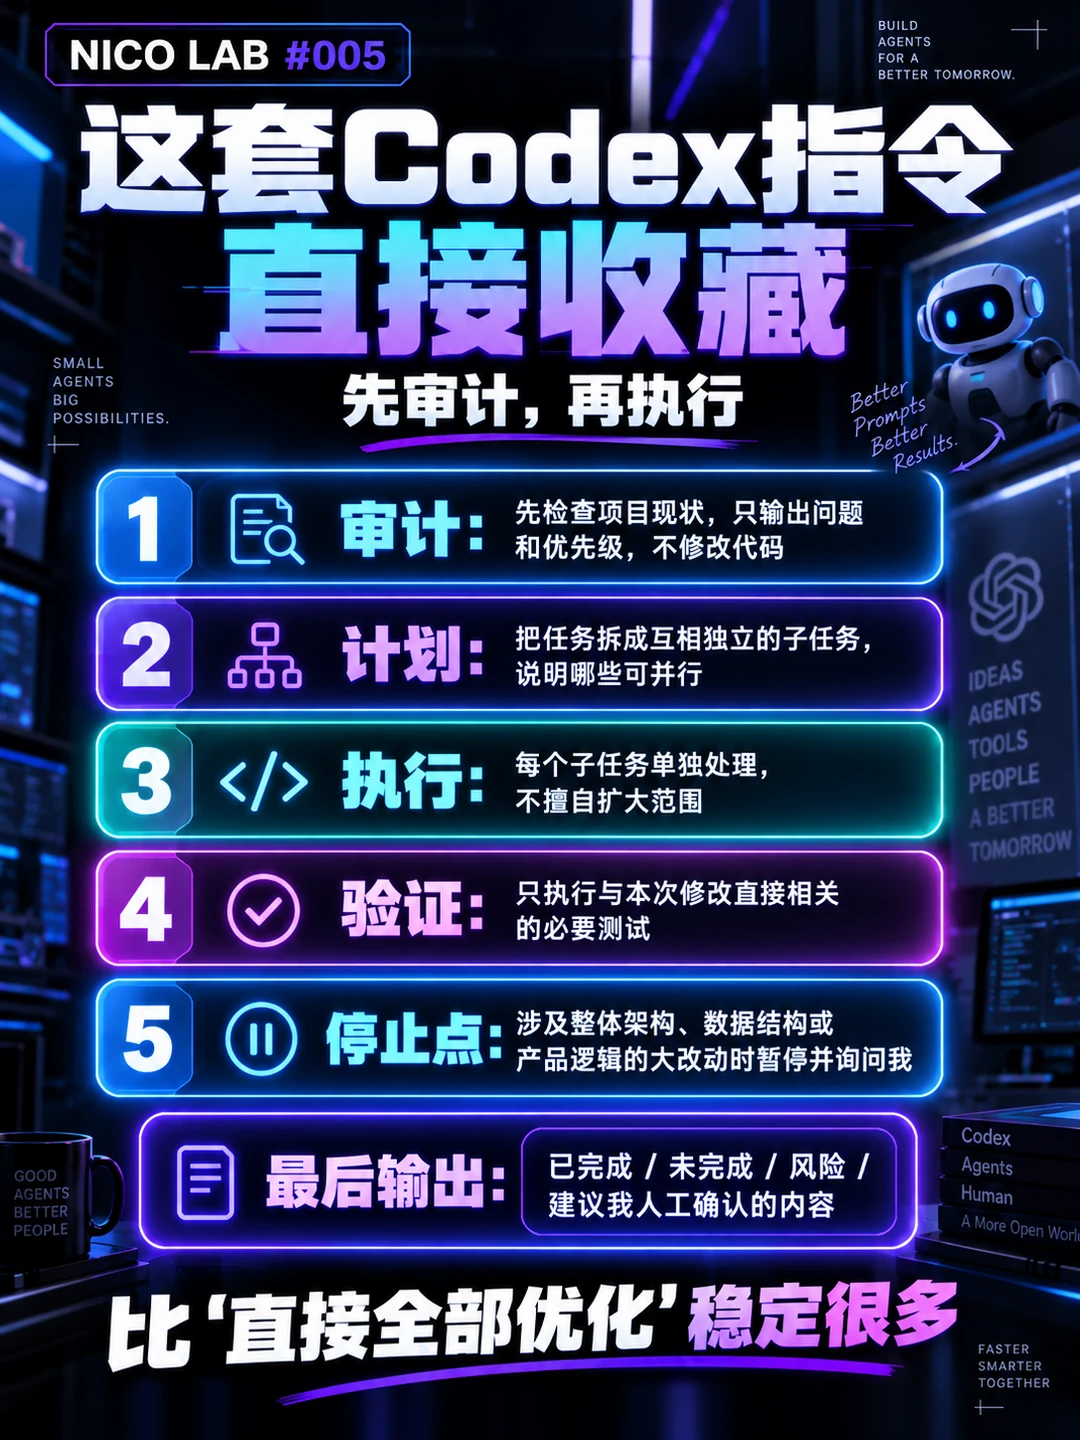
我现在更推荐把大任务拆开。
比如一个App要整改,我不会再让同一个Agent同时分析产品、改代码、跑测试、做验收。可以先让一个Agent只负责审计问题,一个负责真正修改,一个负责测试,最后再让另一个站在审查视角检查有没有遗漏。
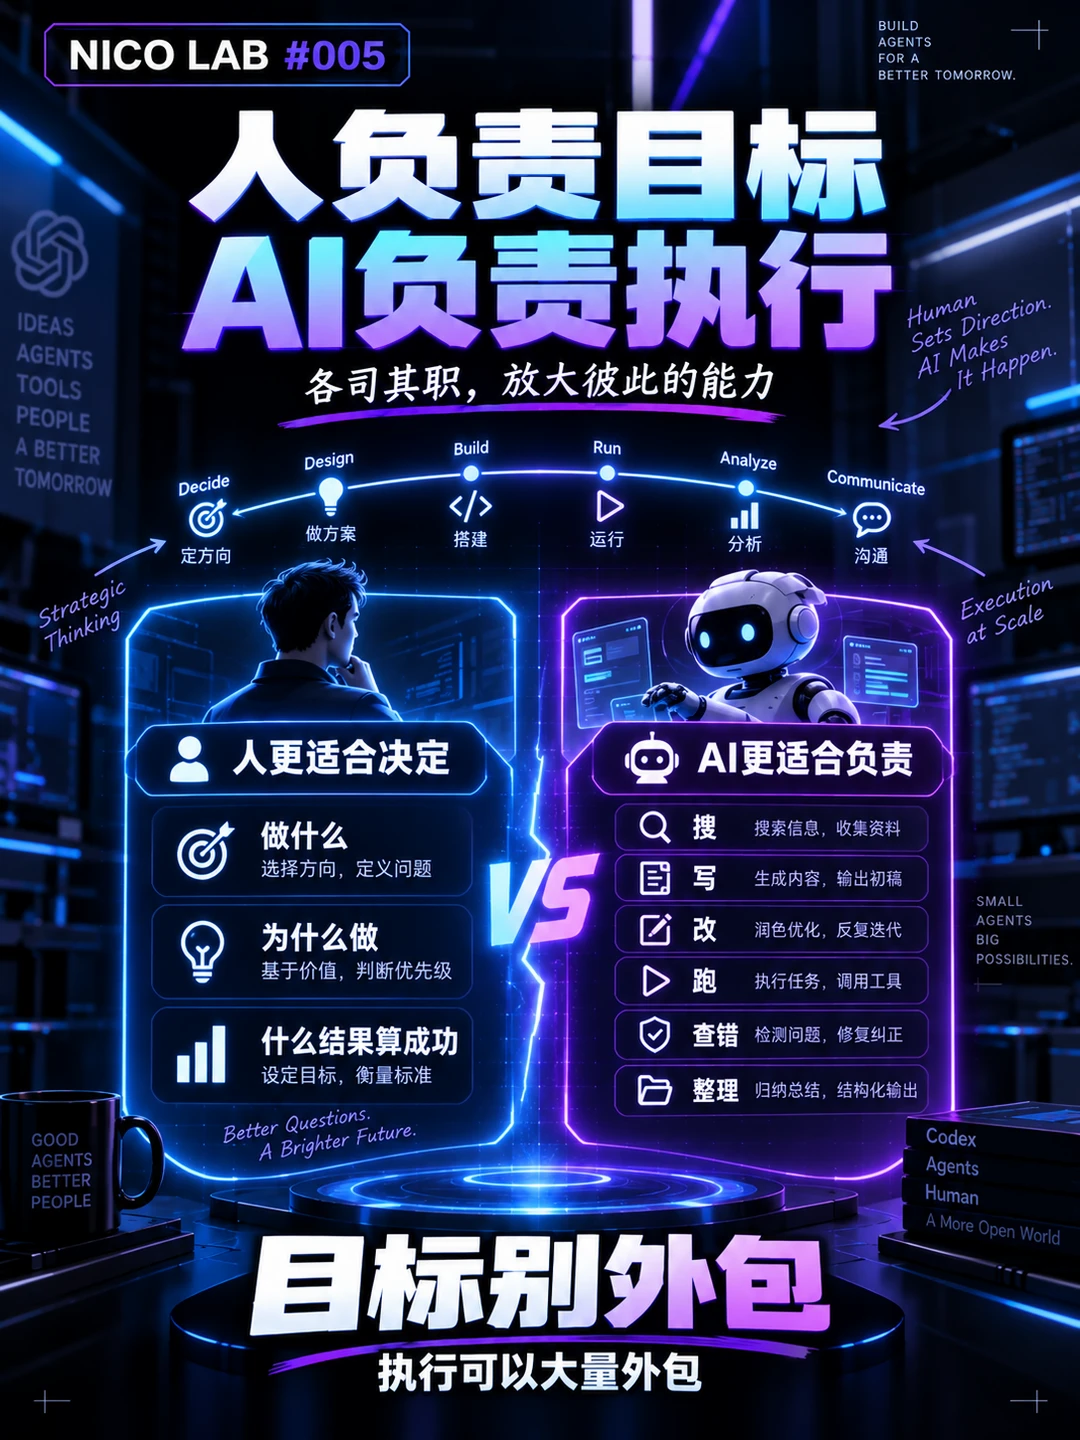
人真正需要控制的是:最终目标是什么、哪些修改值得做、什么结果才算合格。
AI去负责那些耗时间的执行过程。
OpenAI自己的研究数据其实也能看到类似趋势。Coding Agent正在越来越多参与Build、Run、Analyze这些工作,但高层规划目前仍然只占Agent输出很小的一部分;另外他们还发现,Agent特别擅长处理技术排障,一些过去需要人工答疑的内部支持工作也因此减少了。
所以我觉得Agent时代真正要学的可能已经不是“怎样写一个1000字Prompt”。
而是:怎样把一个真实工作拆成AI能稳定执行的任务,以及什么时候应该让人重新介入。这个比再收藏50个Prompt有用得多
#Codex #ChatGPT #AI编程 #AIAgent #AI效率 #NicoAI实验室