谷歌开始算“任务成本”,中科曙光最近这项技术就有意思了
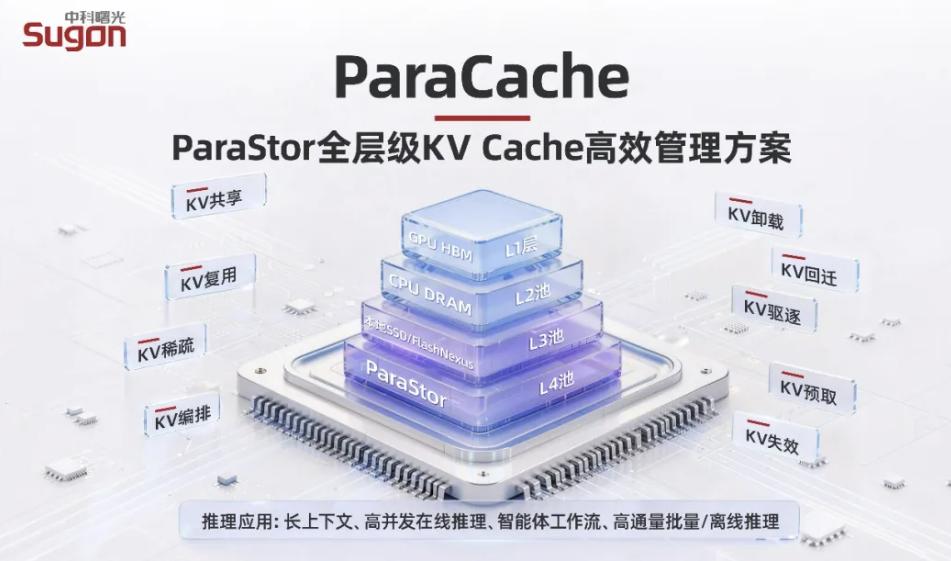
中科曙光最近发布ParaCache,这项技术踩中的可能恰恰是Agent时代最现实的问题。曙光没有继续讨论模型参数有多大,而是盯上了另一件事:为什么已经计算过的内容,还要一次又一次重新计算?
谷歌最新Flash路线很有代表性。模型本身价格可以降,但为了完成复杂Agent任务,它会不断规划、调用工具、失败重试,再进入下一轮循环。结果就是单个Token便宜了,一项任务最终消耗的Token却可能更多。
这时候,AI成本真正该看的已经不是“每百万Token多少钱”,而是“把这件事办完多少钱”。
ParaCache的思路正好从基础设施层解决这个问题:把已经算过的KV Cache保存下来,在GPU显存、CPU内存、SSD和分布式存储之间分层管理、跨请求复用。公开测试中,约12万Token输入时首Token等待时间最高下降98.5%。但具体收益当然会随业务场景变化。
AI进入Agent时代后,我越来越觉得,省一次重复计算,可能和多买一点算力同样重要。
中科曙光 ParaCache 人工智能 AI智能体 大模型