Token生成效率怎么提?中科曙光给了一个新答案
今年数博会“词元”这个主题,说到底是在探讨一个问题:Token的生成效率怎么提?
大模型推理的Token生成,消耗的不只是算力,还有存储和网络。单点强没用,得协同。中科曙光的曙光8000思路就是“算、存、网、冷”全栈协同优化,减少数据搬运和通信时延,让每个部件都发挥最大效能。
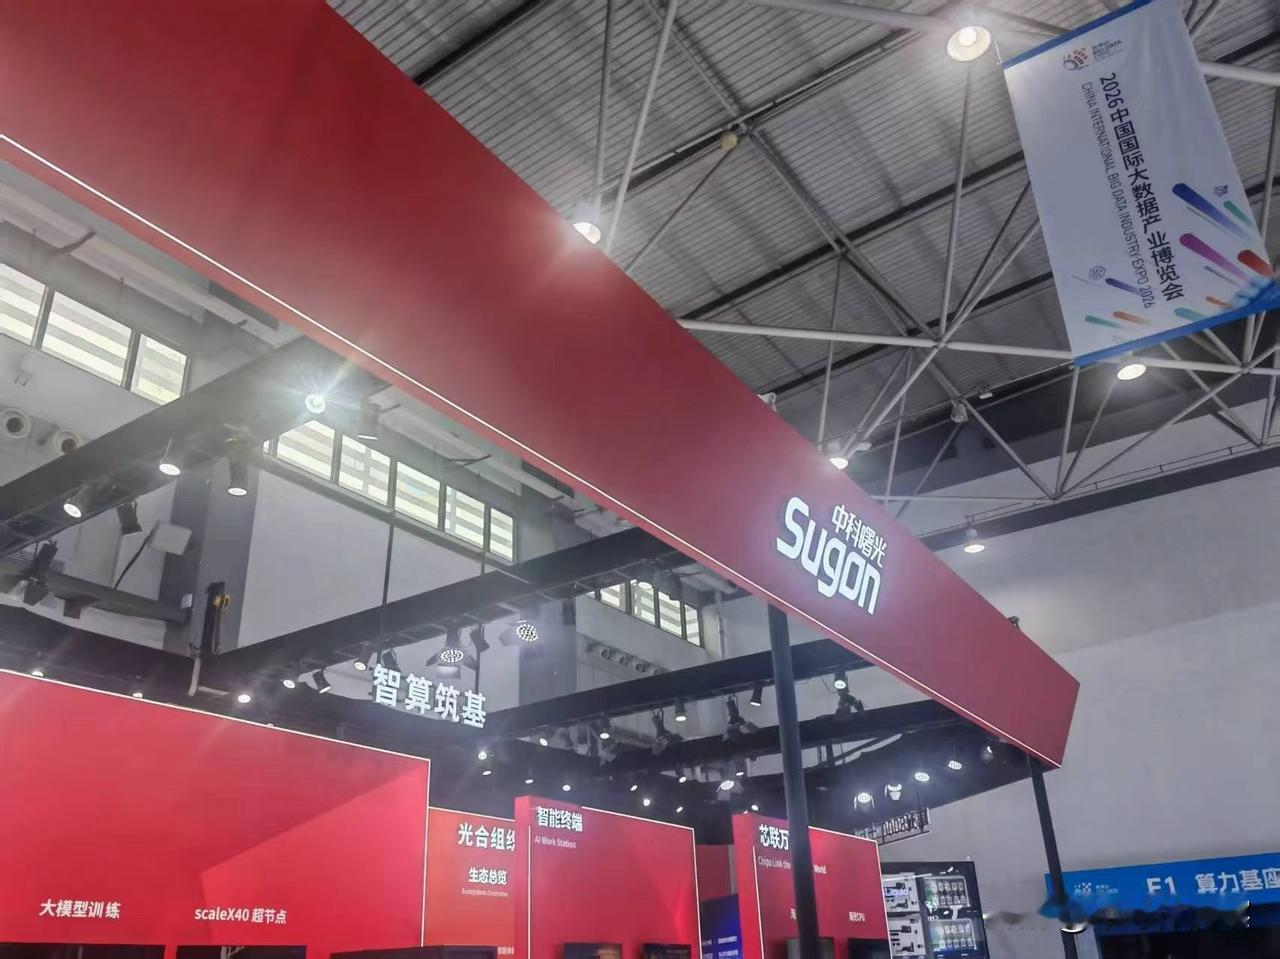
我在展台看到曙光8000液冷计算单元的展示时,同去的一个做AI服务的哥们感慨这散热方案太狠了,PUE能做到1.04。确实,浸没式相变液冷或许不是新鲜事,但做到单机柜MW级功率密度的,全球也没几家。
现场了解到,中科曙光28号还要发布一个词元加速方案。这个方案在长上下文多轮对话、高并发推理服务、轻量级硬件部署等核心AI推理场景的实际应用中,都已经取得了突破性的进展。具体内容等28号揭晓,但方向已经很明显了,词元时代,得“算、存、网、冷”一起发力。
数博会 Token 中科曙光