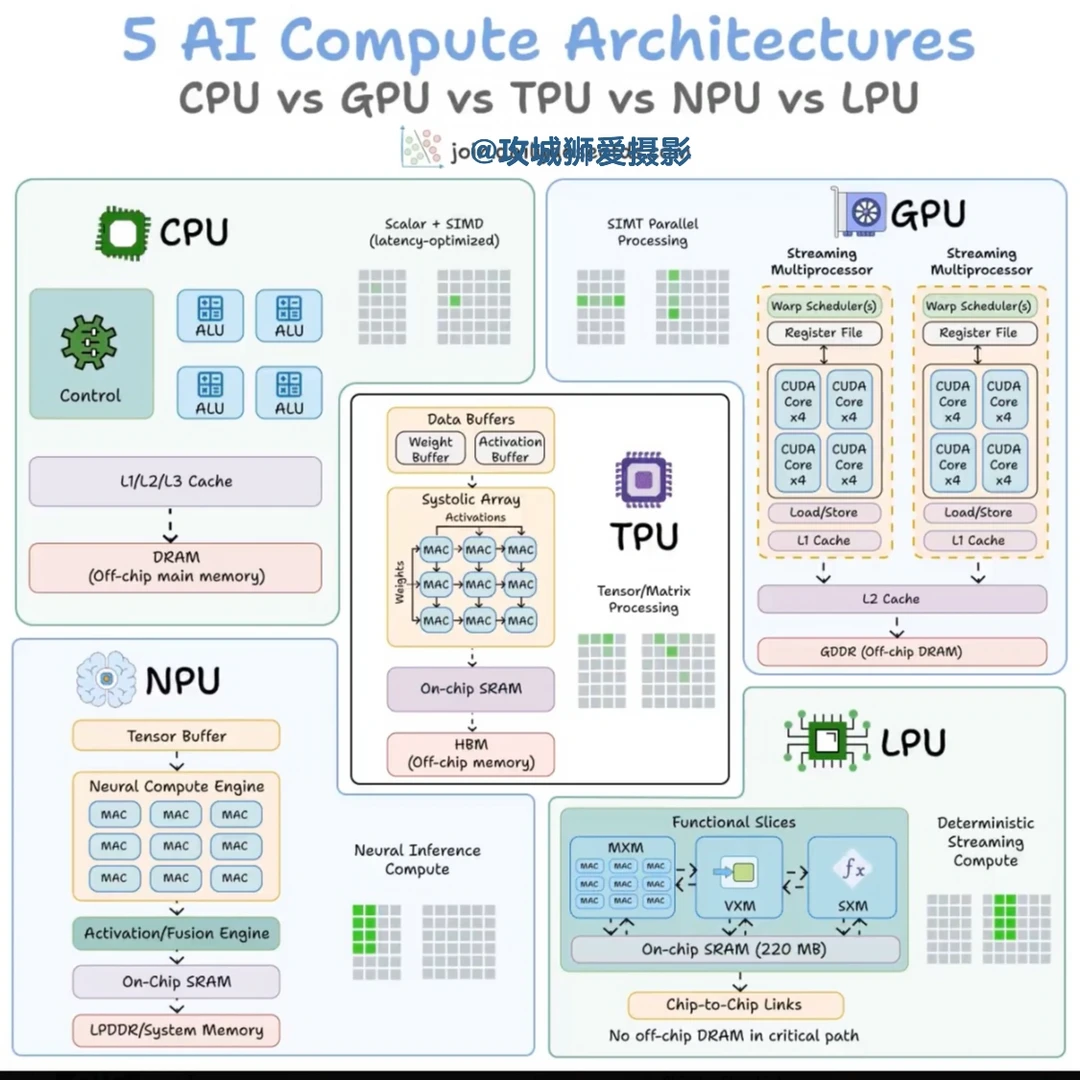
CPU vs GPU vs TPU vs NPU vs LPU,视觉化解析:
如今有 5 种硬件架构驱动人工智能。
每一种都在灵活性、并行性和内存访问之间做出了根本不同的权衡取舍。
> CPU
它专为通用计算而设计。少数强大的核心处理复杂逻辑、分支和系统级任务。
它拥有深层缓存层次结构和片外主内存(DRAM)。它非常适合操作系统、数据库和决策密集型代码,但不适合像矩阵乘法这样的重复数学运算。
> GPU
GPU 不是采用少数强大核心,而是将工作分散到数千个较小的核心上,这些核心对不同数据执行相同的指令。
这就是为什么 GPU 在 AI 训练中占据主导地位。这种并行性直接映射到神经网络所需的数学运算类型。
> TPU
它们在专业化方面更进一步。
核心计算单元是一个乘累加(MAC)单元网格,数据以波浪模式流动通过。
权重从一侧进入,激活从另一侧进入,部分结果传播时无需每次都返回内存。
整个执行过程由编译器控制,而不是硬件调度。谷歌专门为神经网络工作负载设计了 TPU。
> NPU
这是边缘优化的变体。
架构围绕神经计算引擎构建,内部填充了 MAC 阵列和片上 SRAM,但不像高带宽内存(HBM),NPU 使用低功耗系统内存。
设计目标是在个位数瓦功率预算下运行推理,例如智能手机、可穿戴设备和物联网设备。
苹果神经引擎和英特尔的 NPU 遵循这种模式。
> LPU(语言处理单元)
这是最新进入者,由 Groq 推出。
架构完全移除了片外内存在关键路径上的存在。所有权重存储都位于片上 SRAM 中。
执行过程完全确定性且由编译器调度,这意味着零缓存未命中和零运行时调度开销。
权衡在于,每芯片提供的内存有限,这意味着需要数百个芯片链接在一起来服务单个大型模型。但延迟优势是真实的。
AI 计算已从通用灵活性(CPU)演变为极端专业化(LPU)。每一步都以某种程度的通用性换取效率。
下面的视觉图将这五种的内部架构并排映射。
注意连接所有五种的线程。每代的存在都是为了减少数据移动,因为数学运算从来不是难点。难点在于足够快地为数学单元提供数据。
同样的战斗在软件层面上一层展开。在 LLM 推理过程中,单个 GPU 每天产生数 TB 的 KV 缓存,其中几乎全部被丢弃并重新计算,这就是代理工作负载成本如此高昂的一个主要原因。
#硬件 #科技 #芯片