当AI戴上“隐形眼镜”——揭秘能让机器产生幻觉的“对抗样本”
你有没有想过,一张肉眼看起来毫无问题的照片,却能让最先进的人工智能系统彻底“看走眼”?这不是科幻电影,而是人工智能安全领域最棘手的问题之一——对抗样本(Adversarial Examples)。
一、什么是“对抗样本”?
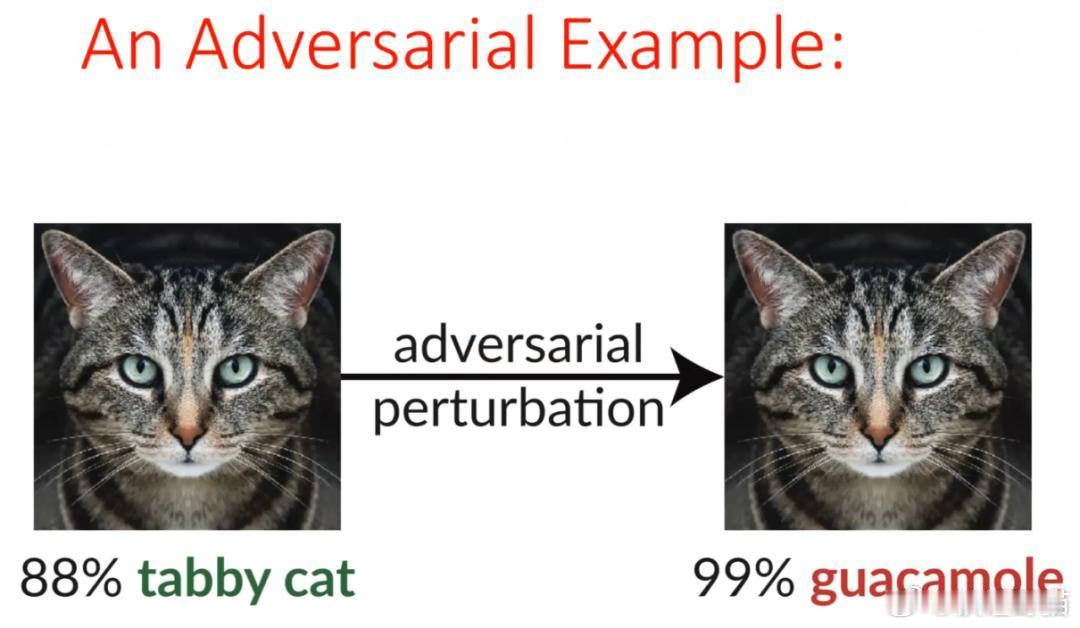
简单说,对抗样本就是攻击者精心设计的数据,它们和正常数据看起来几乎没有区别,但只要喂给AI模型,就能让模型以极高置信度给出完全错误的输出。
一个经典案例:一张熊猫的照片,AI原本能以57.7%的置信度正确识别为熊猫。攻击者在图片上叠加了一层人眼完全察觉不到的微小“噪声”——结果呢?AI以高达99.3% 的置信度认定这是一只长臂猿。人眼看不出任何区别,机器却彻底“幻觉”了。这类攻击不只针对图像——文本、语音同样可以构造对抗样本。
二、为什么AI这么容易被骗?
这和我们人类“看”东西的方式完全不同。我们识别一只熊猫靠的是眼睛、经验和常识;而深度学习模型本质上是把图像看作一串数字,通过层层数学运算来分类。
研究人员发现,很多神经网络具有线性特性——输入中微小的变化经过多层权重放大后,会在最终结果上产生巨大偏差。就像你在安静的房间里轻声说句话没人注意,但在演唱会现场哪怕吼一嗓子也可能被淹没——AI的“听觉”结构决定了它对某些特定方向的扰动特别敏感。
三、现实世界中的威胁
这绝不只是实验室里的把戏:
· 自动驾驶:研究人员在停车标志上贴几张小贴纸,AI就可能将其识别为限速标志,导致车辆不停车直接通过路口。也可以让停车标志在检测器眼中彻底“消失”。· 人脸识别:攻击者可在授权用户的人脸图像上添加人眼不可见的噪声,欺骗门禁或支付系统。· 大语言模型:在ChatGPT等模型输入中添加特定字符序列,就能诱导模型生成虚假或有害信息。· 最新进展:清华大学和蚂蚁数科在2025年NeurIPS上提出的Dual-Flow框架,已能实现“指哪打哪”——只需指定想攻击的类别,就能自动生成欺骗多种模型的对抗图像。
四、如何防御?
研究者们也在积极构建“疫苗”:
· 对抗训练:主动生成对抗样本加入训练集,让模型提前“见过”这些骗术,提高免疫力。· 输入净化:在数据进入模型前先进行压缩或去噪处理,滤除可能的扰动。· 模型增强:设计更鲁棒的模型架构,从根源上减少对微小扰动的敏感度。
这就像一场永不停息的猫鼠游戏——攻击者不断发明新的欺骗方式,防御者则不断加固防线。
五、为什么这很重要?
随着AI渗透到医疗诊断、金融风控、自动驾驶等关键领域,对抗样本的威胁已从学术问题变成现实挑战。一个被欺骗的AI系统,可能导致误诊、交通事故甚至安全漏洞。
理解对抗样本,不仅是在了解一个技术概念,更是在看清人工智能的边界与局限。当机器越来越聪明,我们越需要知道——它们会在什么地方“犯傻”。
(本文可自由转载,科普用途,欢迎分享)人工智能#人工智能机器人##样本对抗#