为了对比,把原版BF16的和4bit量化的Qwen3.8-27B稠密模型都部署到本机了,4bit的速度凑合16.5Tokens/s,两个版本的水准还分别在试。端侧能力密度和算力密度的提升(后者更慢),会不会使得一年之内类似“笔记本电脑+便携版多模态Opus-4.8”这样的可能出现?如果M7 Max、AI MAX 495的迭代版、RTX Spark 2.0、RTX6090这四个里其中一个能够算力精进的话。前三个的统一内存带宽瓶颈也到了需要通过LPDDR6X和“内存总线-位宽”解除一下的时候了。
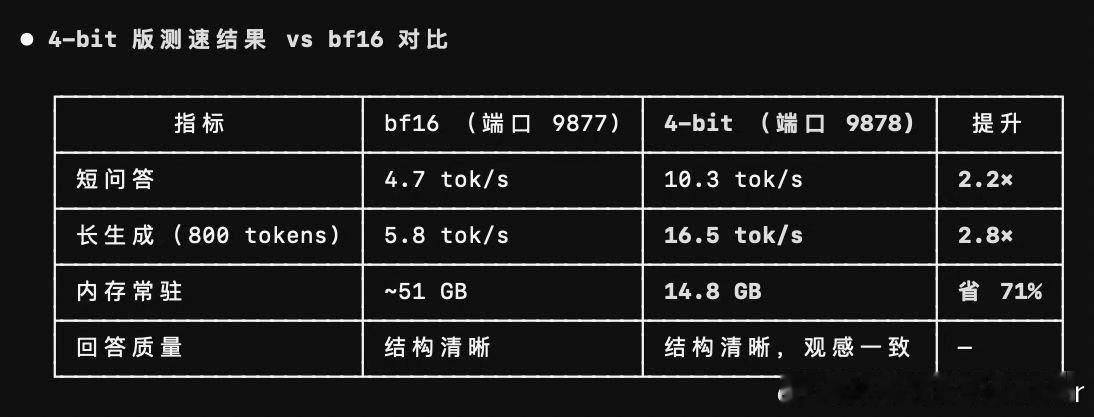
为了对比,把原版BF16的和4bit量化的Qwen3.8-27B稠密模型都部署到本机了,4bit的速度凑合16.5Tokens/s,两个版本的水准还分别在试。端侧能力密度和算力密度的提升(后者更慢),会不会使得一年之内类似“笔记本电脑+便携版多模态Opus-4.8”这样的可能出现?如果M7 Max、AI MAX 495的迭代版、RTX Spark 2.0、RTX6090这四个里其中一个能够算力精进的话。前三个的统一内存带宽瓶颈也到了需要通过LPDDR6X和“内存总线-位宽”解除一下的时候了。