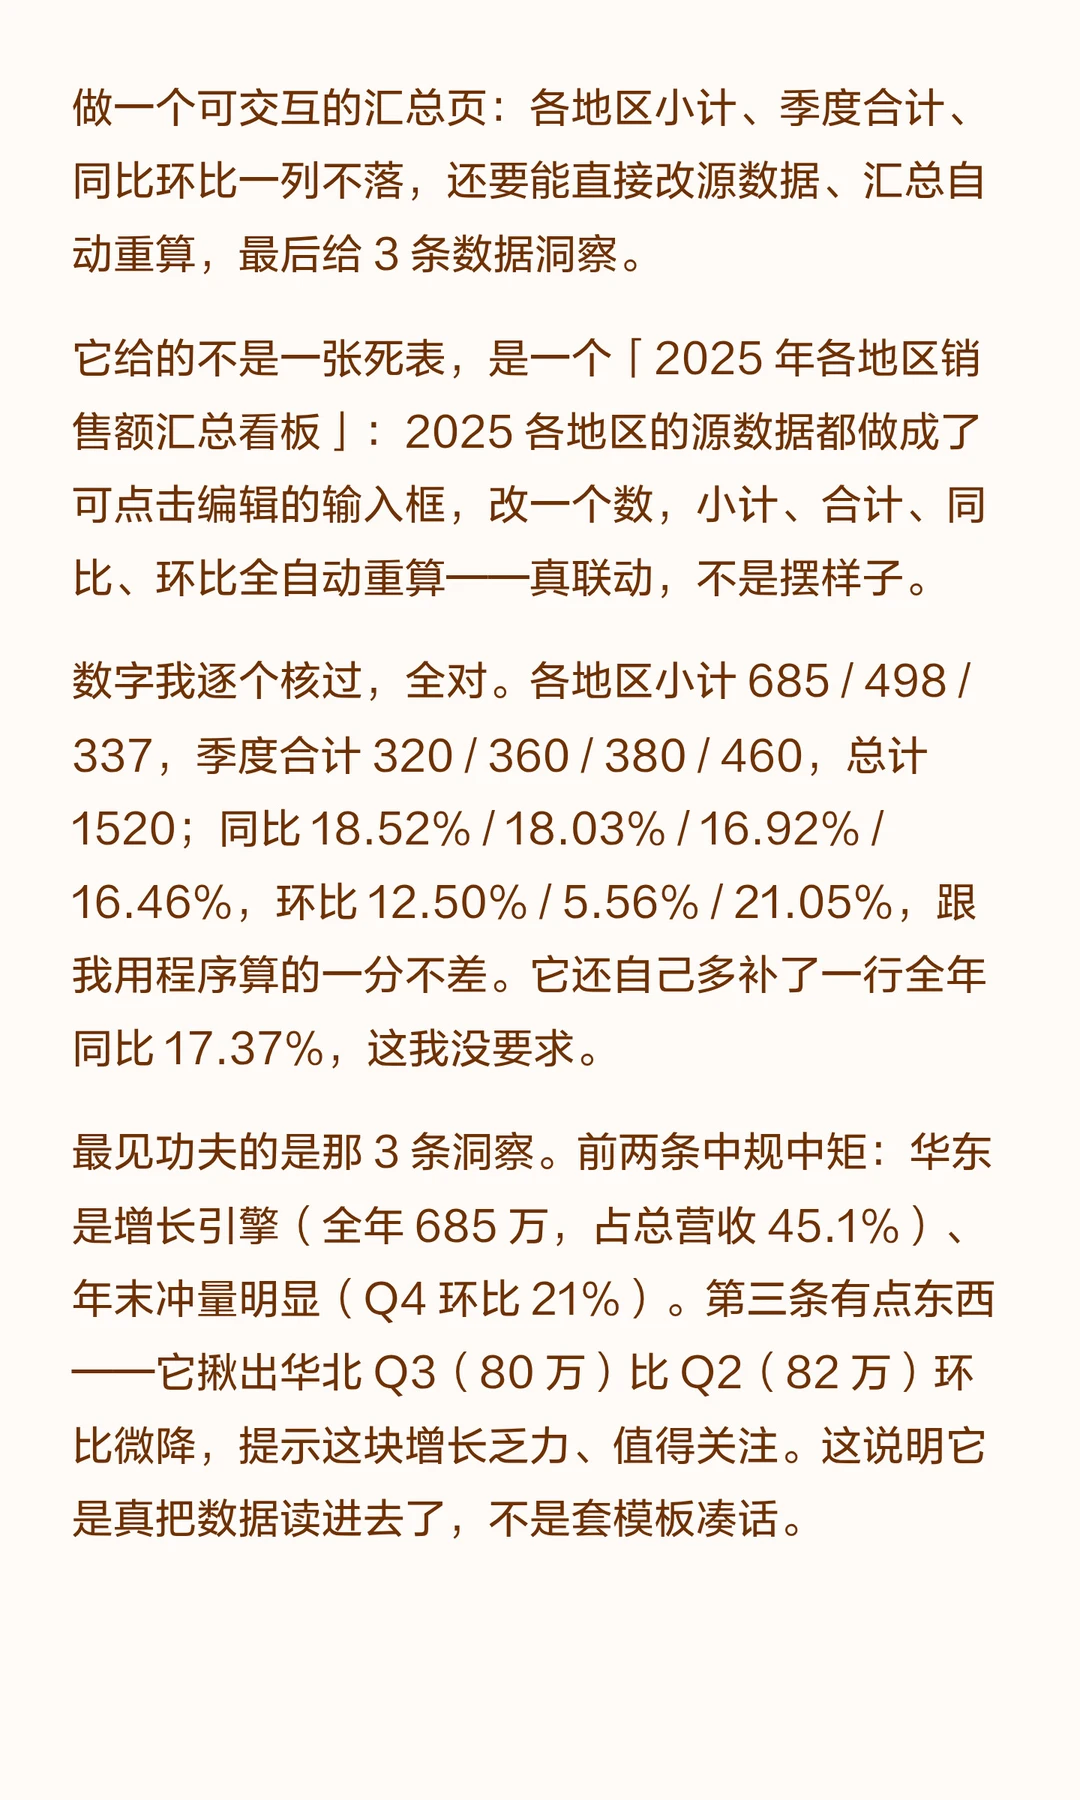
这两年发布会听得太多,参数一个比一个大,PPT 一张比一张炸,真拿去干活,掉链子的不少。所以这次腾讯混元 Hy3 上来就说「小尺寸掰手腕大模型」,我第一反应是:又来。
直到我把它的参数表和定价页摆到一起看,又上手跑了几天活。
结论先放这儿:这不是又一个「参数怪兽」,它走的是另一条路——单位参数,尽量多干活。
/01/ 先把账摆上桌算下
Hy3 是 MoE 架构,总参数 295B,激活参数 21B,最大支持 256K 上下文。
关键看激活参数——21B。做个对比:GLM5.1 总参数 744B,激活 40B。Hy3 的激活参数,差不多是它的一半。
这是什么概念?激活参数越小,单次推理调动的算力越少,成本和速度都跟着往下走。
但小归小,官方给的能力位置并不低:Agent 测评介于 GLM-5.1 和 GLM-5.2 之间,推理层面对标 DeepSeek V4 pro、Qwen 3.7 max。
详细文章见上方图片……
Hy3 在腾讯云的定价:输入 1 元/百万 tokens,输出 4 元/百万 tokens,命中缓存的输入只要 0.25 元/百万 tokens。
这是什么水平?简单说,跑一个中等复杂度的日常 Agent 任务,成本压得很低;缓存一命中,输入这块几乎可以忽略。
我越来越觉得,模型这场竞争,前半程比「能不能做对」,后半程比「用多少钱、多长时间做对」。
token 效率和耗时,会是模型和 Agent 产品接下来真正要卷的东西。Hy3 给我的感觉,是提前站到了这条赛道上。
一个侧面数据能说明问题:据官方口径,从 Preview 到正式版,Hy3 在 WorkBuddy 上的日均 tokens 消耗涨了 4 倍。
这个数不是靠发布会涨的,是被全球开发者拿真实活儿一点点喂出来的。这种「场景锤炼」出来的提升,比跑分实在。
从 Preview 到正式上线,Hy3 只用了 2 个月。
这背后是一整套基础设施的重构和研发链路的跑通——脚手架、数据、训练,一条线打通了。
链路通了意味着什么?意味着这次是 21B 激活,下一次可能就是更大尺寸、更高性能,而且迭代会越来越快。
所以 Hy3 值得关注的,不只是它现在这一版有多能打,而是它背后那条已经跑顺的「越级打怪」的路。
小尺寸能掰手腕,只是开始。