刚好,你又是开了一台具备高阶辅助驾驶的车子,请问,你希望得到什么样的反馈和反应?
在探讨「天外来物」具体为何物之前,我们先探讨一个关于人的问题。
美国NHTSA(国家公路交通安全管理局)的数据显示,人类驾驶员的平均感知—反应时间约为1.5秒。在120km/h的时速下,1.5秒意味着车辆向前行驶约50米。
把这个数字再拆分一点:120km/h,每0.1秒,车辆行进3.3米。0.1秒听起来很短,但真实道路上,就是一辆车横跨两个车道的距离。
高规格辅助驾驶拼的从来不是「有没有看见障碍物」,看见是必须的,但识别不一定,主要确定事障碍物,核心就是能不能在零点几秒里做出判断。
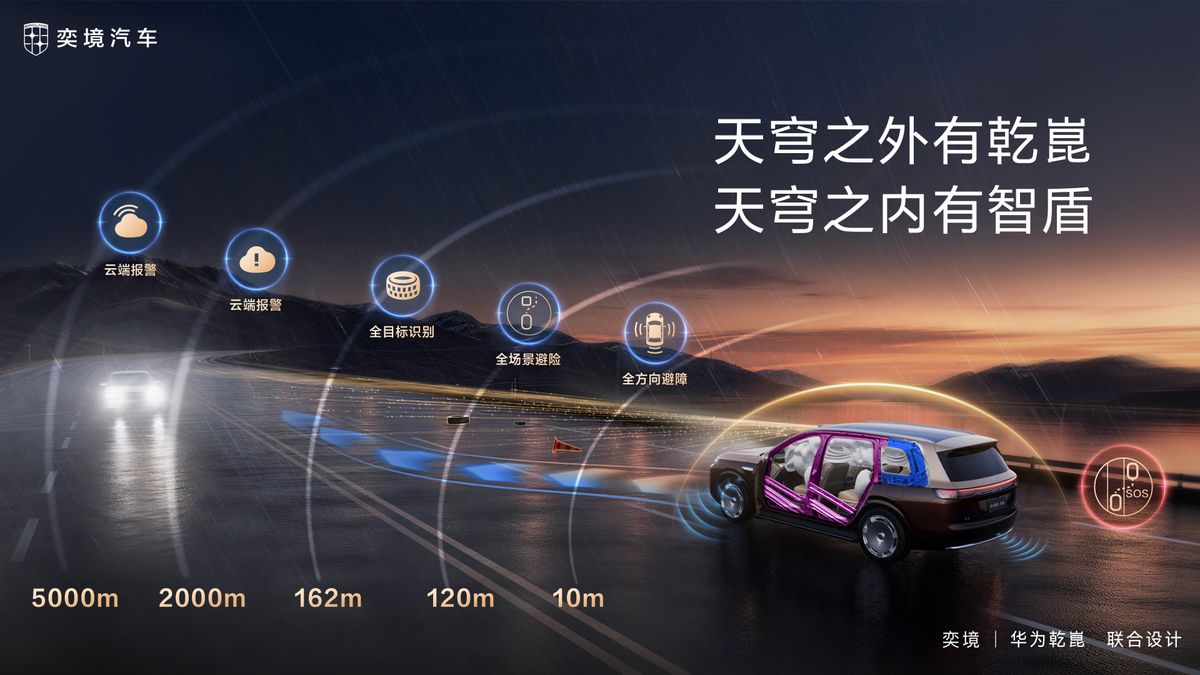
奕境X9搭载的华为乾崑ADS 5方案,就是围绕「眼疾、脑快、手稳」展开,这套系统独占了感知、决策、兜底三层核心能力,这三层的权重超过六成,底盘执行在三层之后。
今天我们从这三层入手,看看它是怎么把「0.1秒的价值」变成真实安全余量。
眼疾:四激光雷达,看得见还得看得早四激光雷达不是堆料,是为了更早发现异形障碍物
提到激光雷达,很多人的第一反应是"堆数量",四激光雷达的价值,不是数量本身,而是解决了一个核心问题:异形障碍物的漏检。
什么是异形障碍物?
就是那些不在标准训练集里的东西,包括但不限于掉落的家具、散落的建材、侧翻的车辆、甚至路面上的大坑。
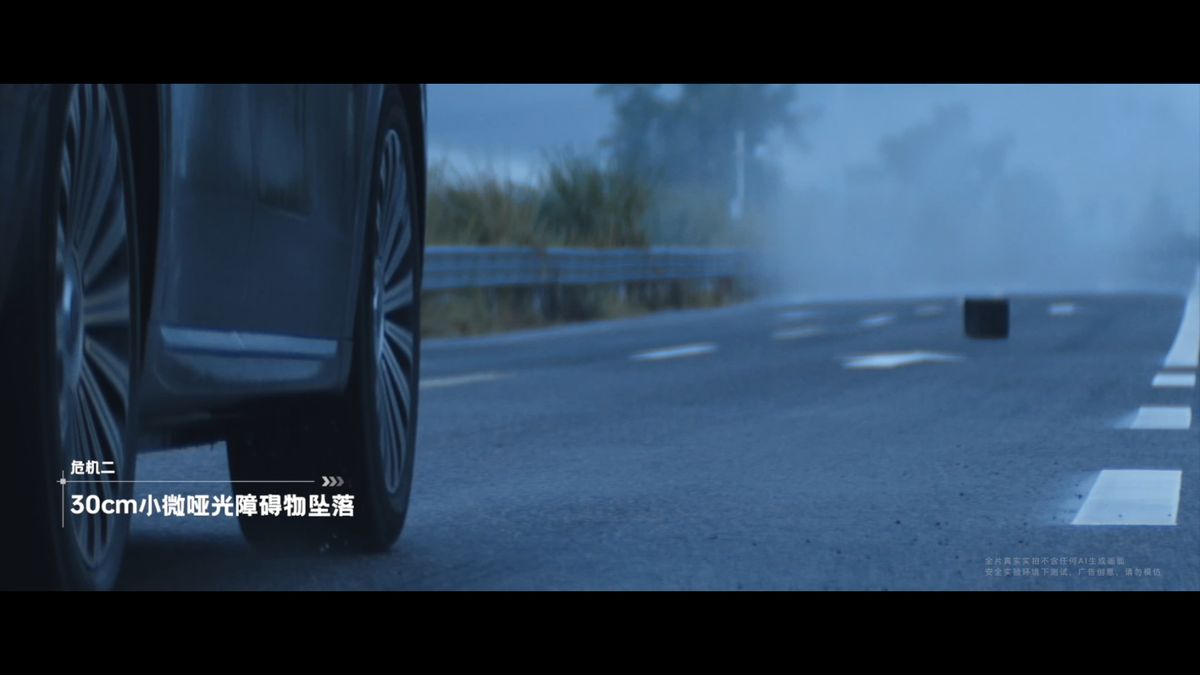
普通单激光雷达方案,往往只覆盖正前方一个狭窄视角,一旦障碍物从侧面切入、或者被前方大车遮挡,容易出现盲区。
四激光雷达的方案,相当于给车辆装了四只眼睛:前向、侧向、后向,多视角互补,任何一个方向出现的异形障碍物,至少两只眼睛能同时看到。
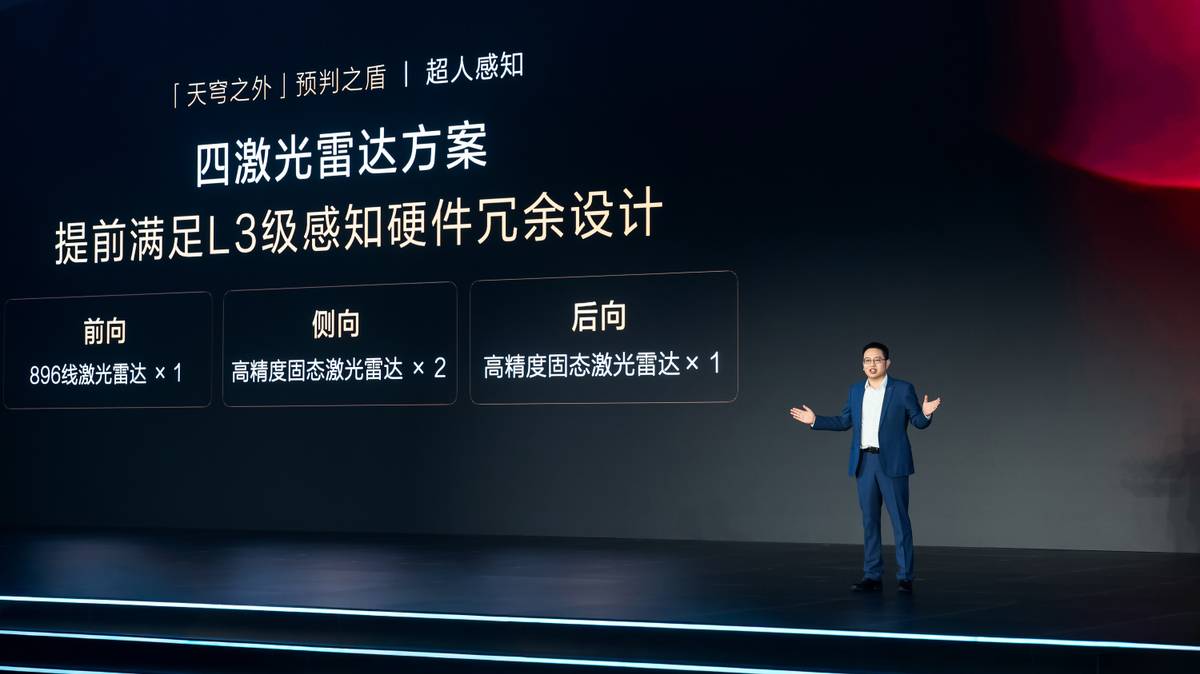
这不是简单的看清楚,而是从概率上降低了漏检可能,这是应对「天外来物」最关键的一步。
早1秒看见,等于多出33米的决策空间
关键是时间。
高速场景,障碍物不是静止的。对向驶来的车、前方掉落的物体,相对速度可能超过200km/h。这时候,提前0.1秒和晚0.1秒识别到目标,结果是天壤之别。
120km/h下,0.1秒对应约3.3米的行驶距离。早1秒意味着多出33米的决策和避让空间。
33米差不多是半个标准篮球场的长度。
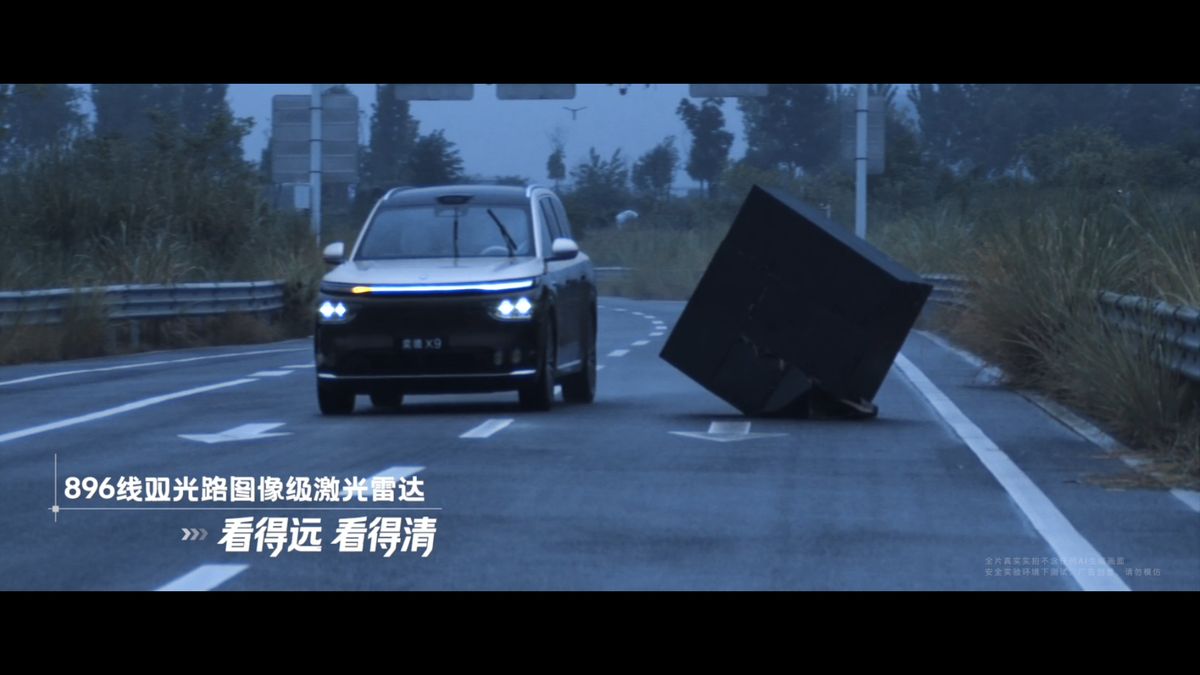
这就是高规硬件的意义:它不是为了让你「看得见」,而是为了让你「更早看见」,抢出来的每一秒,都可以直接换成安全距离,但光看见还不够。
四激光雷达每秒采集的点云数据是海量的,这些数据涌进来之后,怎么做快速判断?紧接着就是决策计算。
脑快:WEWA 2.0世界模型,思考时延压到极致为什么是世界模型,而不是VLA?
感知层把环境数据采集上来之后,需要一个大脑来做博弈推演:障碍物会不会移动,应该刹车还是变道,旁边和后面有没有车?
行业目前主流技术路线有两种:一种是VLA(视觉-语言-动作)方案;另一种是华为选择的WEWA世界模型方案。
世界模型的优势是,少一层翻译,少一份时延,这是华为的逻辑,两点之间,直线最短。
VLA方案的核心,是把感知环境信息翻译成语言描述,再由大模型推理得到结果。听起来很美,在高速紧急工况下,翻译本身需要时间。少一层信息转换环节,少一层时延损耗,多一层效率。
0.1秒决定生死的场景,每一步省下的时间,都是真金白银的安全余量。
WEWA 2.0的硬实力:博弈能力×10,风险降50%
奕境X9搭载WEWA 2.0世界模型,在能力上有几个关键提升:
第一,博弈推演能力提升10倍。
这意味着能同时推演更多个场景分支,把周围车辆、行人、障碍物的可能行为都算进去,而不是只看眼前,这是防御性驾驶。
第二,学习效率提升10倍。新场景、新路况的适应速度更快,系统不是死记硬背,而是能快速举一反三,这是学会推理。
第三,场景风险预估降低50%。遇到危险场景,系统可以更早识别路上的潜在隐患,主动做出防御性驾驶响应。
CAS 5.0安全兜底:能刹就刹,刹不住就让
快速决策能力之后,还需要一套兜底策略,这就是CAS 5.0。
CAS 5.0的逻辑非常清晰:
首先是AEB自动紧急制动:条件允许,全力刹车,能刹就刹,最直接、最有效,只要制动距离够,先把车停下来。
其次是eAES紧急主动转向:刹车距离不够了,这时候就不能只刹车了,需要主动打方向,做到刹不住就让。
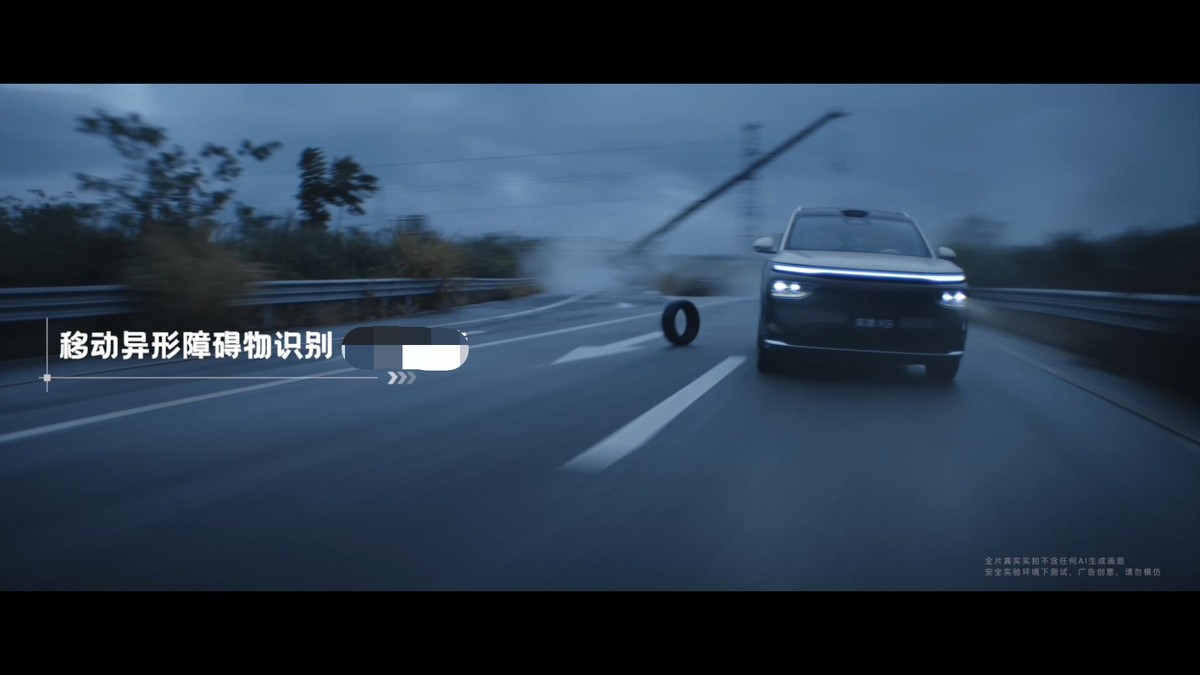
两套策略配合WEWA 2.0快速决策,构成了一套完整的应急反应链路:看见障碍物 → 快速判断 → 最优避险 → 刹车或转向。
于是,我们就来到了最终的执行层面,想得太快,执行太慢,那不就眼高手低了吗?
手稳:XMC赋能的华为赤兔平台,把决策快速兑现为车辆动作底盘是最终的执行者
感知和决策是核心,底盘负责执行。只是,好的感知和决策,需要迅速、敏捷的底盘执行,否则争分夺秒出来的优势也会被凭空消耗掉。
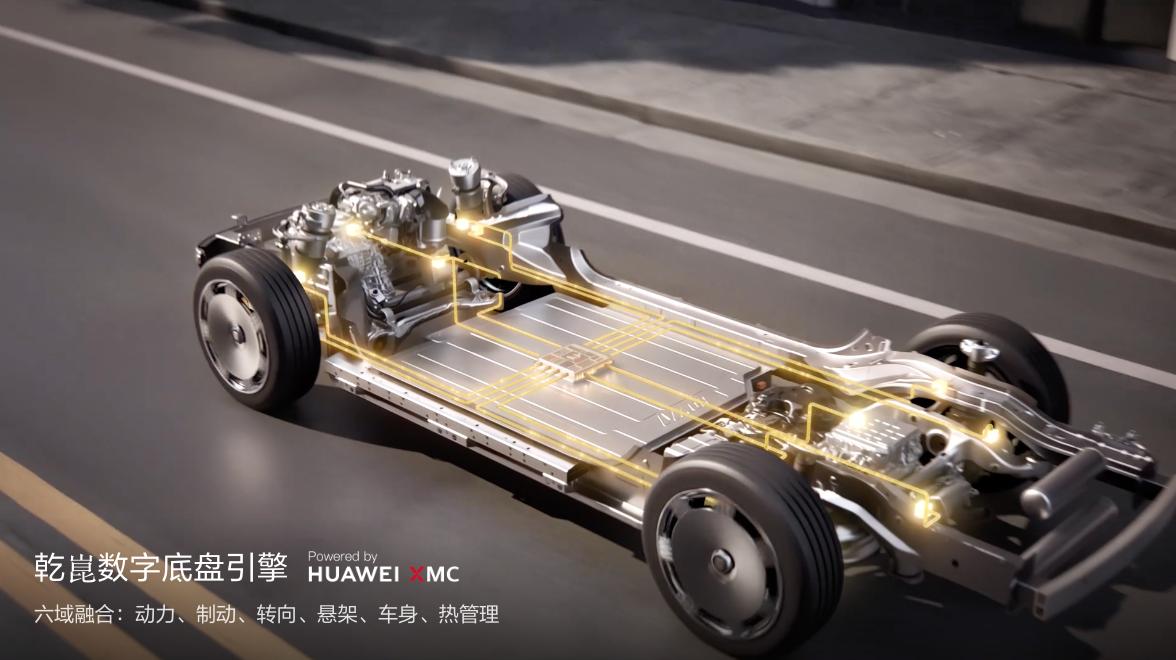
传统辅助驾驶方案,辅助驾驶和底盘是两套独立系统。
辅助驾驶系统推导「需要紧急制动」,从辅助驾驶域控制器传到整车控制器,再传到制动系统,每经过一个节点,都要时间。
奕境X9的华为乾崑ADS 5方案做了一件很关键的事:感知、决策、执行三层原生打通。
辅助驾驶可以直接调度转向、制动、悬架,不需要层层上报再层层下发,像大脑直接指挥手脚,而不是大脑告诉颈椎、颈椎告诉肩膀、肩膀告诉手。
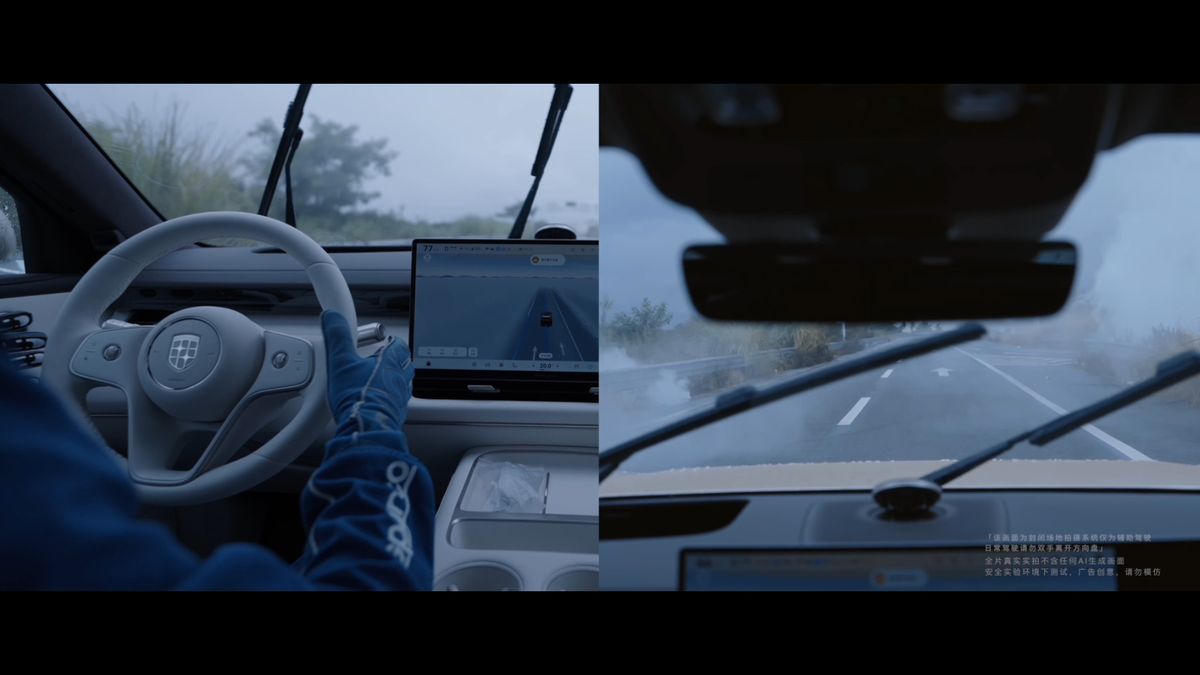
300毫秒就是10米
传统液压制动方案的响应时间,在300到600毫秒之间。奕境X9搭载的XMC线控底盘方案,响应时间120到150毫秒。
两者最高相差接近300毫秒。
120km/h的时速,300毫秒对应10米,差不多两台车身位。
也就是说,面对同样一个障碍物,同样的感知、同样的决策,传统底盘方案在踩下刹车这个动作上,比XMC线控底盘少了10米的制动距离。突发事故,10米可能就是安全和事故的分界线。
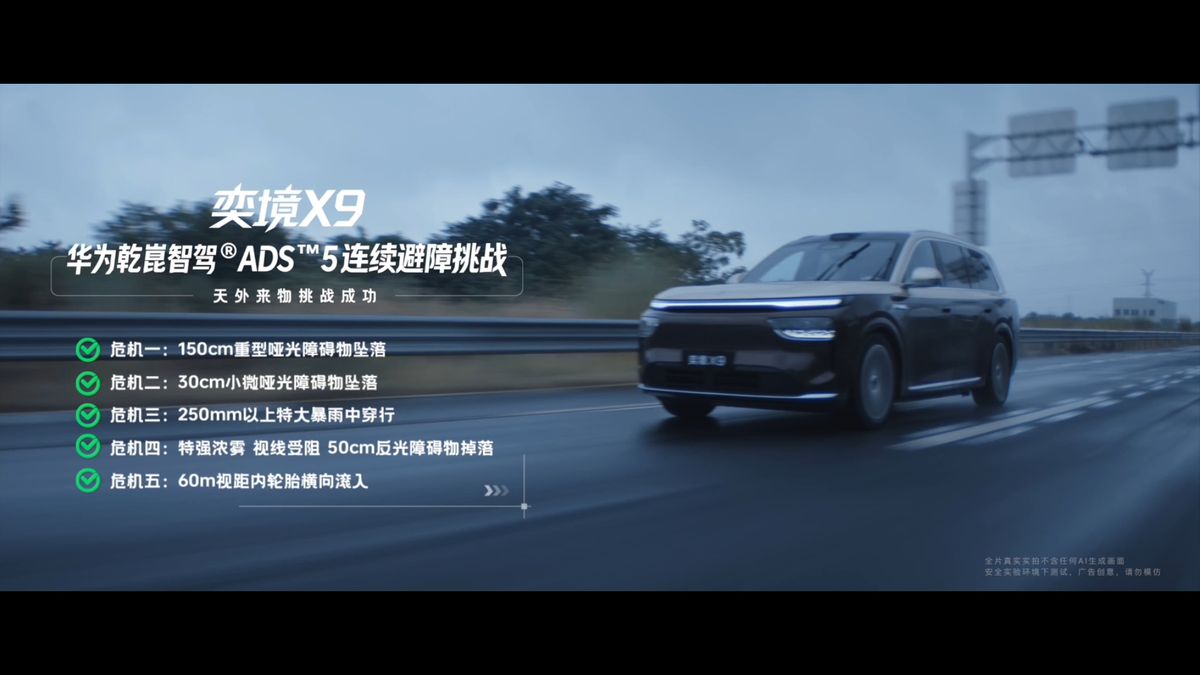
不只刹车快,避让也快
线控转向也是低时延,当CAS 5.0的eAES策略决定刹不住就让,需要紧急变道时,转向指令可以秒级落地。
刹车快、转向慢,避让时会卡住。手稳,是刹车、转向、悬架全部协同响应,把眼疾和脑快争取到的每一秒、每一米,真正兑现成车辆动作。
最终,我们就发现,面向L3,一体化设计才是正解。
让我们复盘一下整条链路:
感知层的四激光雷达,解决的是「看得见、看得早」,这是眼疾;
WEWA 2.0世界模型加CAS 5.0安全兜底,解决的是「算得快、算得对」,这是脑快;
XMC原生线控底盘,解决的是「指令快速落地」——这是手稳。
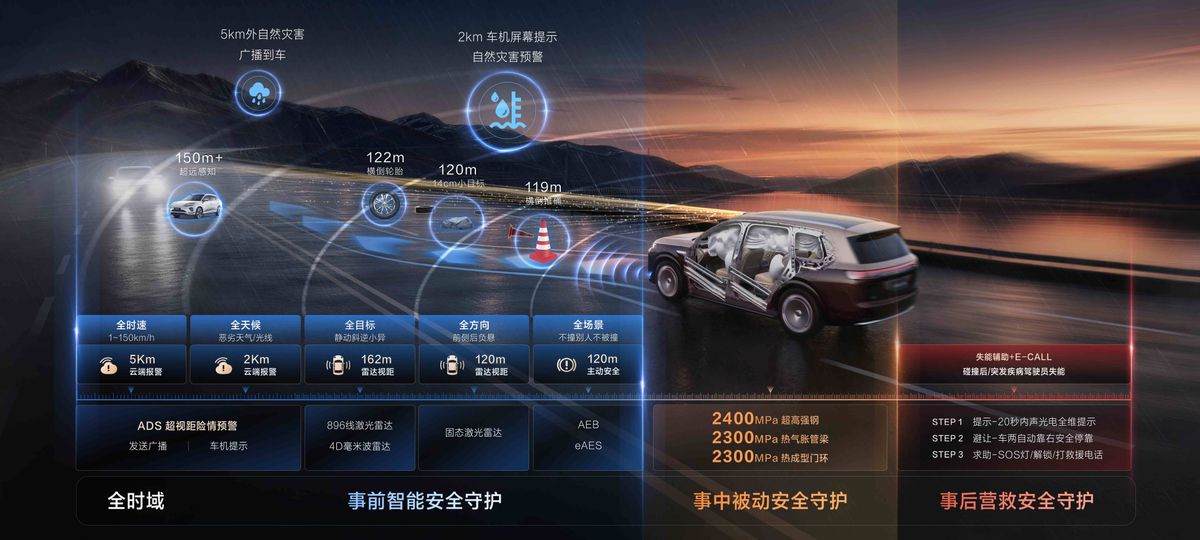
三层加在一起,构成了一套完整的高规格辅助驾驶系统。单靠任何一层,都解决不了「天外来物」的极端场景。
这也正是ISO 21448 SOTIF(预期功能安全)标准的核心理念:辅助驾驶安全不是靠某一个硬件堆出来的,而是靠感知—决策—执行全链路的一体化设计来保障的。面向L3级别的高规格辅助驾驶,单点硬件再强,没有系统级的整合,都是纸上谈兵。