一、一个 812 行的 SKILL.md,是怎么变成税的前几天翻一个项目的 skills 目录,看到一个文件夹叫 py-style。打开里面的 SKILL.md,812 行。
写的人非常认真。三年攒下来的 Python 规范全在里面:模块怎么命名、函数怎么命名、常量怎么命名、日志用哪个库、日志级别怎么选、什么异常该吞什么异常该抛、目录怎么分、测试文件放哪儿、哪些第三方库不许引进来、什么样的写法算"太聪明"。我能想到的它都有。
这份东西质量很高。问题在于它放错了地方。
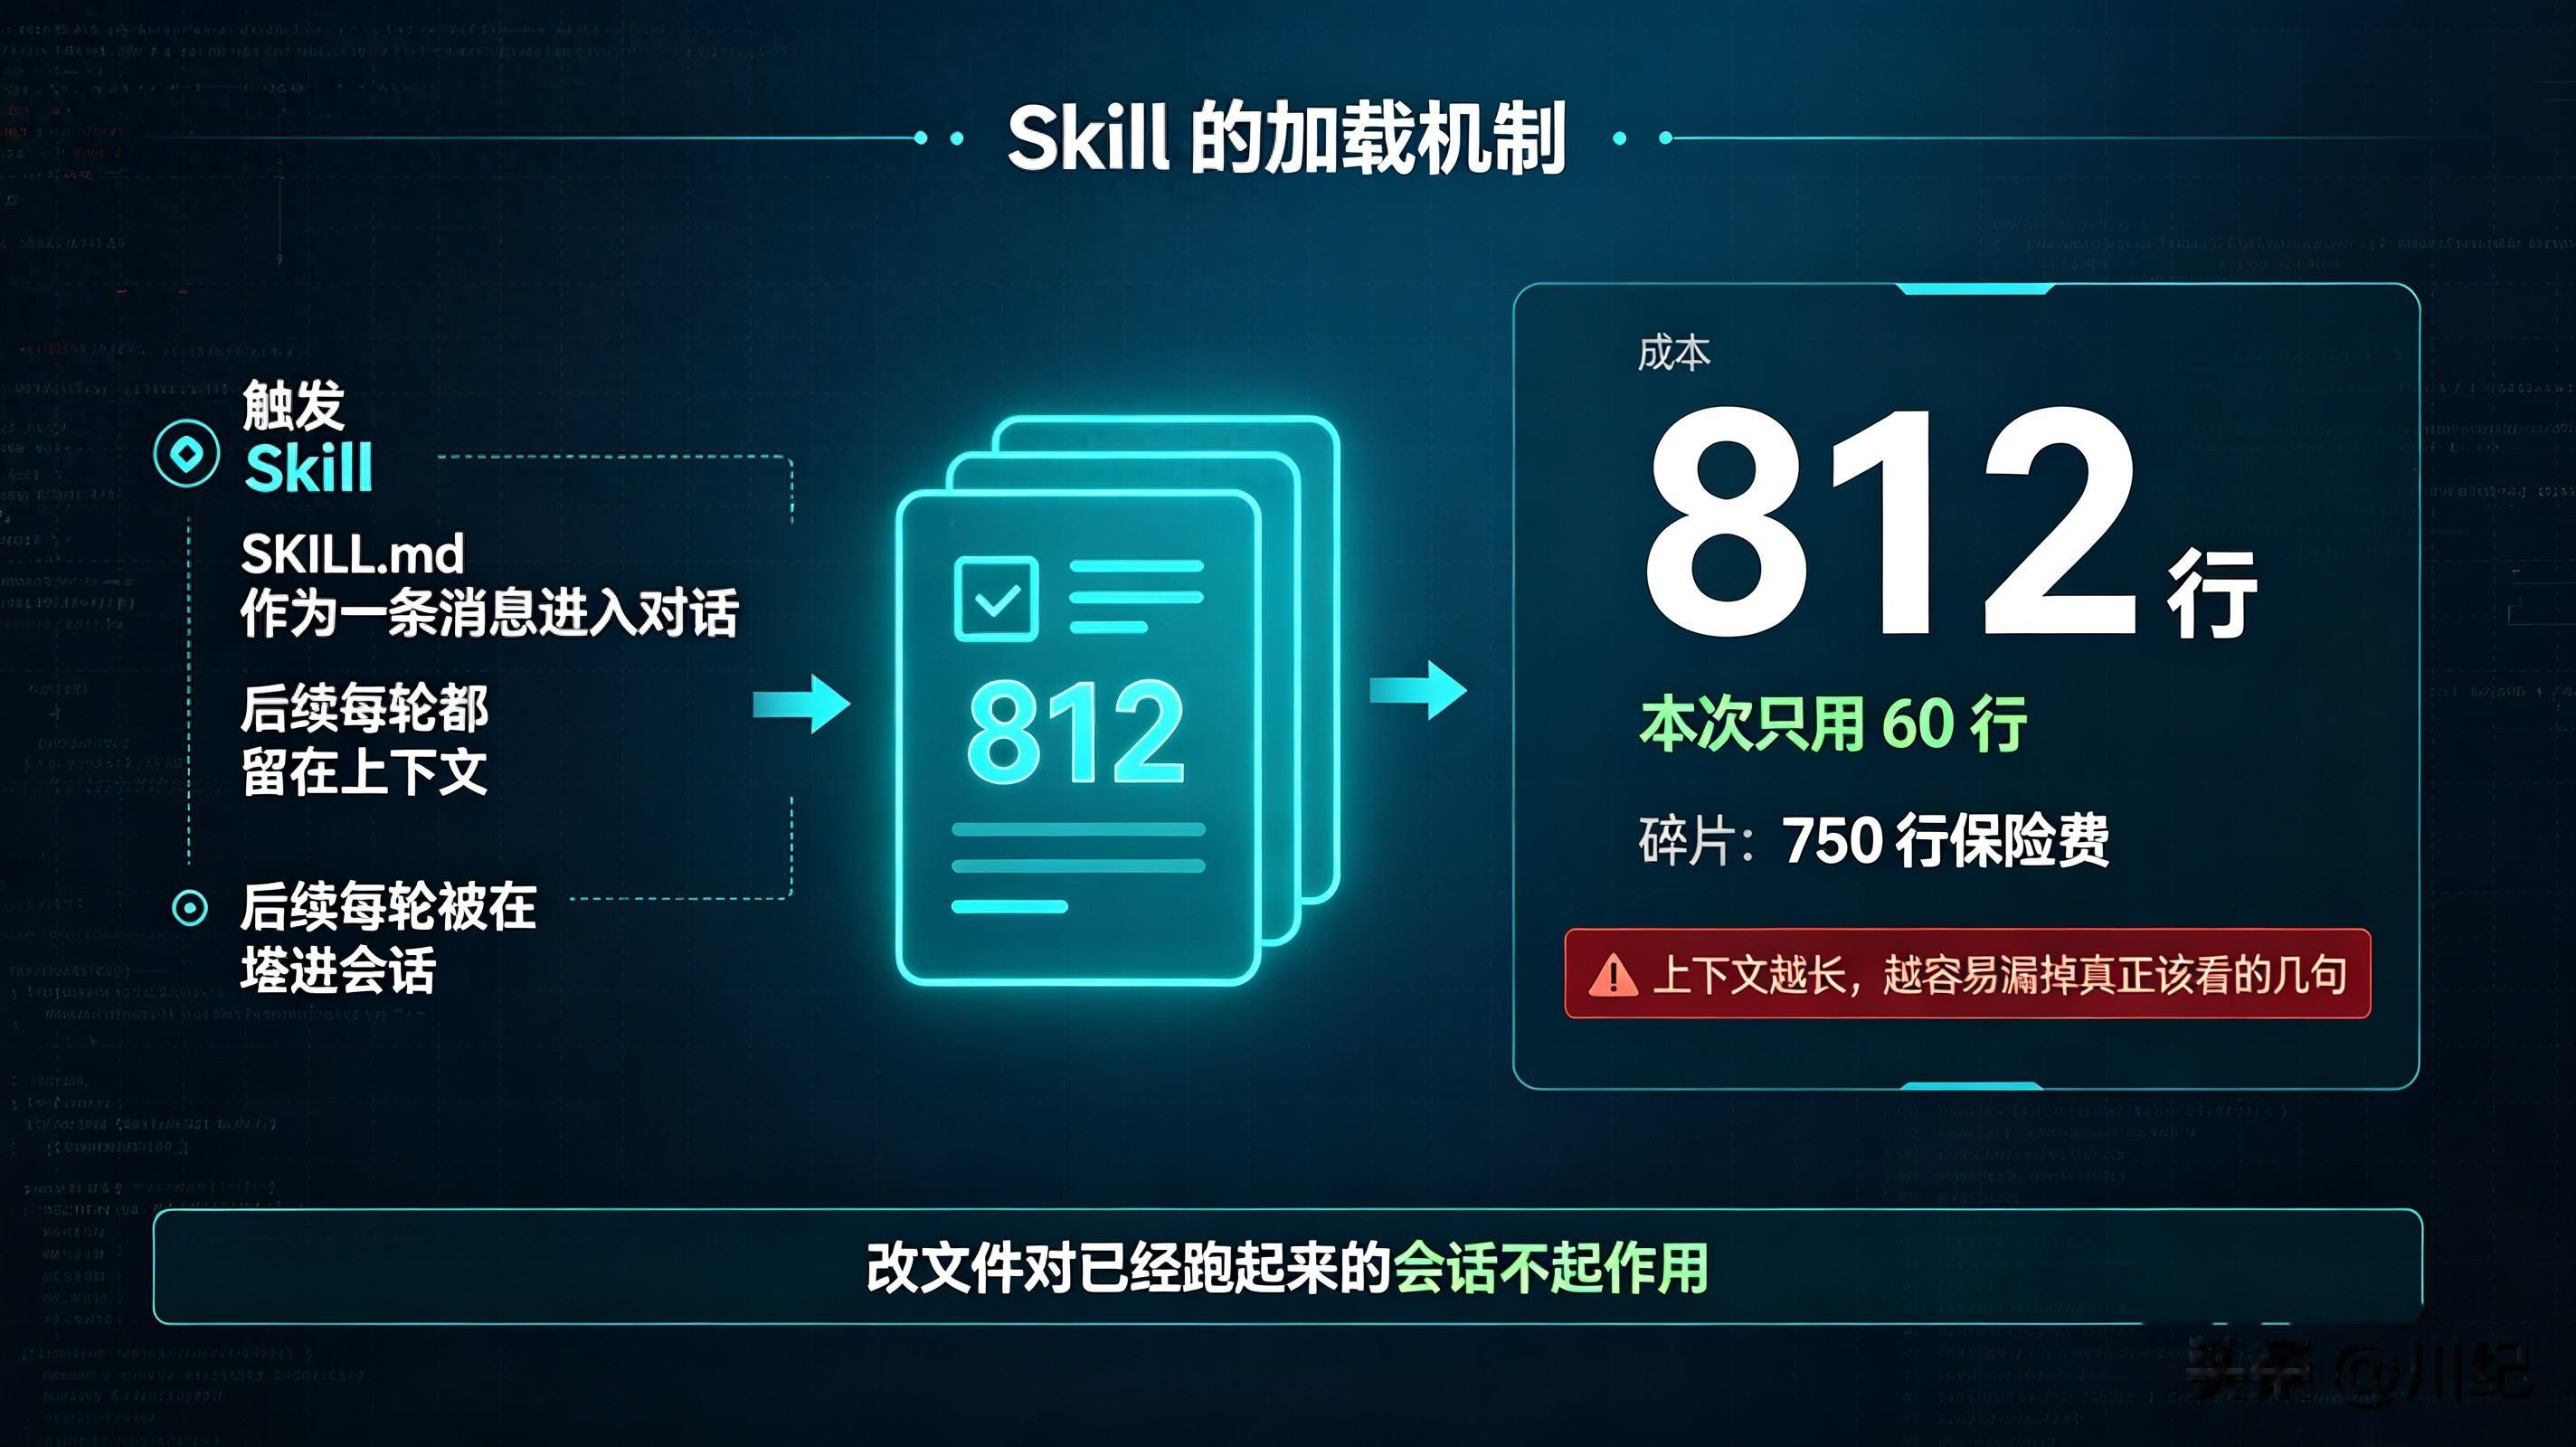
Skill 的加载机制是这样的:一旦被触发,SKILL.md 的内容作为一条消息进入对话。而且它不会自己走。官方文档的原话是这么写的:
When you or Claude invoke a skill, the rendered
SKILL.md
content enters the conversation as a single message and stays there across later turns. ... Claude Code does not re-read the skill file on later turns.
两层意思。第一,它进来之后会一直留着,影响后面每一轮。第二,它不会在下一轮重新读文件——所以你在会话中间改了 SKILL.md,当前这一轮生效的仍然是进来时的那一版。改文件对已经跑起来的会话不起作用,这一点很多人是踩过一次才明白的。
于是那 812 行的真实成本不是"读一次",是从触发那一刻起,每一轮都在读。你后面聊二十轮,它就陪着二十轮。
做个很粗的算:一屏中文大概是 800 到 1000 字,812 行的规范文件差不多是两三万字。这个体量灌进去,等于每次调这个 Skill 都在你的窗口里先塞一篇长文,然后再开始干活。
而这 812 行里,真正在这次任务里被用上的,我数了一下,大概 60 行。剩下 750 行是你为"万一哪天用得上"交的保险费。
更亏的地方在后面。上下文越长,模型越容易漏掉真正该看的那几句。你把 812 行灌进去,结果它可能连该用哪条命名规则都没抓住——写得越多,它记住的反而可能越少。这不是玄学,是注意力的问题:一份两万字的规范里,跟当前任务相关的那 60 行不会自己跳出来。
我自己有个特别具体的体感。会话跑到三四十轮的时候,前面那些"什么都要管"的大文件还在窗口里,而真正要它记住的那两三句约束已经被淹了。你回头怪模型不听话,其实是你自己把噪声和信号一起倒进去了。
这不是"写得不够好"造成的。写的人一点没偷懒,他把该记的都认真记下来了。错的是载体:一份给模型看的说明书,被写成了给新人看的入职手册。这两者的区别是,入职手册允许你随时翻,说明书只在被打开的那一秒开始计费。
这篇要解决的问题就一个:怎么把它拆薄,同时不丢东西。
这套做法有个通用叫法,叫渐进式披露(progressive disclosure)。官方文档里没有直接用它起名字,但把规则写得很清楚:什么东西放在哪一层、什么时候被读,都是有说法的。
二、SKILL.md 是地图,不是仓库先说清楚一个位置关系。SKILL.md 不是知识仓库,它是地图。

仓库的写法是"把所有东西都搬进来",地图的写法是"告诉你有什么、在哪儿、什么时候去拿"。
官方示例目录里,my-skill 下面第一行的标注是这么写的:
├── SKILL.md (required - overview and navigation)两个词:必需,和概览与导航。导航才是它真正的角色。
你想想去一个陌生城市怎么办:你不会把整座城的门牌号背下来,你带一张地图,到了哪个区再查那个区的路。地图比城市小得多,但它是通往城市的入口,而且它永远指向最新那一版。
这个比喻里藏着两个不那么显然的点。
第一,地图是要经常改的。城市新增一条地铁,你得更新地图;但地图更新之后,整座城市不需要重建。反过来,如果你的目录结构写错了,你只要改一行指路,那几千字的内容一个字都不用动。这是拆开之后的第一个好处:修改变便宜了。
第二,地图允许同时存在多个版本。你可以有一张"通勤地图"和一张"旅游地图",各画各的重点。落到 Skill 上就是:同一个知识库可以服务好几个 Skill,每个 SKILL.md 只指它自己需要的那几条路。
落到 Skill 上,具体是三层:
层
是什么
什么时候进上下文
第一层
SKILL.md
正文
触发时进,之后一直留着
第二层
同目录的附属文件
Claude 需要哪一块,才读哪一块
第三层
脚本
被执行,不加载进上下文
这里有个常被误解的地方要澄清。第二层和第三层的区别,不是"文件放哪儿",而是"进不进上下文"。
参考文档被读进来的时候,它的内容是进上下文的,占位置。它和省上下文的关系在于你可以选择不读。这一次任务只碰命名,那就只读 naming.md,logging.md 从头到尾没被翻开过,一分钱没花。

脚本不一样。脚本是被执行的:check_style.py 跑一遍,几百行代码本身不进上下文,只有它打印出来的那五行报告进来。这是三种类型里唯一"工作量很大但成本几乎为零"的一种。记住这个区别,后面判断表里会反复用到。
再往下想一层,你会发现这套结构和我们平时写的项目文档是反着来的。项目文档的组织方式是"按主题分章",默认读者从头读到尾;Skill 的组织方式是"按调用频率分层",每一层都假设读者只读自己这一层。所以拆的时候别按主题拆,按频率拆。同一个主题下面的内容,频繁用的和偶尔用的,应该住在两个地方——这也是为什么 naming.md 和 logging.md 是两份文件,而不是一份叫"编码规范"的大文档。按主题拆出来的东西看起来更整齐,但那只是给你自己看的整齐。
三层里,第一层是唯一"躺着也计费"的。所以正文的每一行都要能过一道测试:它是不是每次都用得上。
官方还有一句提醒,写在讲内容类型的那一节里:
Keep the body itself concise. Once a skill loads, its content stays in context across turns, so every line is a recurring token cost. State what to do rather than narrating how or why.
"每一行都是反复发生的 token 成本"——这句话是整篇的地基。后面所有的拆分技巧,都是在回答同一个问题:怎么让跑在正文里的行数尽可能少。
顺带说一句那个 how or why。我们写文档的习惯是把来龙去脉讲清楚,而 Skill 正文要的是指令,不是散文。"为什么这么规定"不是不能写,是不该写在正文里——它属于参考文档。
还得说一句不好听的话:不是所有大文件都值得拆。如果一个 Skill 你一个月用一次,触发后也就跑十轮,那 800 行摊下来没多少。真正值得动手的是那种"天天用、每用一次就跑一两个小时"的 Skill,比如代码风格、提交规范、日志排查这类。频次乘以行数,才是你该看的那笔账。高频的那几个拆干净,收益是立刻能感觉到的;低频的可以先放着,不用一次性把所有东西都重写一遍。
还有个容易忽略的点:地图得能读懂。 附属文件不是把内容藏起来,是把它挪到一个更该待的位置。如果拆完之后 Claude 找不到东西在哪,那不叫渐进式披露,那叫丢三落四。所以拆的时候要连着写一份索引,索引本身就是正文的一部分,而且是最不能省的那部分。
三、官方约定的目录:一个 Skill 就是一个文件夹接下来看官方给的目录约定。
Skills can include multiple files in their directory. This keeps
SKILL.md
focused on the essentials while letting Claude access detailed reference material only when needed.
一个 Skill 就是一个文件夹,SKILL.md 是入口,旁边可以放附属内容。官方文档给了一个示例目录,我把它的原文标注一并抄过来:
my-skill/
├── SKILL.md (required - overview and navigation)
├── reference.md (detailed API docs - loaded when needed)
├── examples.md (usage examples - loaded when needed)
└── scripts/
└── helper.py (utility script - executed, not loaded)四行,四种职责,括号里那句话才是重点。这是官方给的分类,不是我编的:
参考类文档(reference.md)——装详细文档,loaded when needed。定位是"需要的时候才加载"。平时躺在磁盘上,不占你的上下文。它适合装什么?API 细节、完整的字段表、领域背景、还有那些解释"为什么"的内容。
样例(examples.md)——装用法示例,同样是 loaded when needed。这一类的价值经常被低估。对模型来说,一段正例加一段反例,比三段抽象描述管用得多。它不需要你总结规律,它看着例子就能把规律归纳出来。
可执行脚本(scripts/)——executed, not loaded,被执行,不加载。官方自己的示例里,那个生成代码库可视化的 Skill 就是把脚本放在 ~/.claude/skills/codebase-visualizer/scripts/visualize.py,正文里让 Claude 去跑它。脚本的存在形式是"一份可以调用的能力",不是"一段要读的文本"。
第三类和前两类是质的区别,值得单独说。为什么要把一段步骤写成脚本,而不是让模型照着自然语言现做?三个理由:
确定性。同样的输入,代码每次跑出来都一样。自然语言步骤每次执行都可能飘。可测试。脚本你可以单独跑、单独测。一段写在 Markdown 里的步骤,你只能靠"看它做没做对"。不吃 token。执行的时候只有脚本的输出回到上下文里,代码本身不占位置。一个 300 行的检查脚本,跑完可能只回你 5 行结果。这三点里,第二条经常被忽略。你的 Skill 是可以有"测试"的——只要那部分逻辑在脚本里。写进 Markdown 的那一刻,它就永久失去了被测试的可能。
至于模板、字体、图标这类素材,官方示例没有给它们单独的名字,但规则是同一条:放进这个文件夹,并且在 SKILL.md 里写清楚什么时候用它。
那什么时候该新建一份附属文件,而不是在正文里多加一段?我的标准是四十行。一段内容超过四十行、又不是每次都用,就值得单独一份文件;不到四十行的,先放正文里,等它长到四十行再说。别为了结构好看把两行字单独拆成一份文件——那只会让你多一次读取往返,收获为零。
反过来说,如果你发现自己连着建了七八份附属文件,每个都只有五六行,那也不是好结构。文件数量本身不是目标,每一层装的东西都配得上它的成本才是。
还有个细节值得知道:这些文件是相对 SKILL.md 的位置来找的,整个文件夹可以整体搬走。这也是它后面能被打包、能分发的前提。
再补一句:这几类文件不是必须全都有。一个 Skill 只有一份 SKILL.md 也完全合法,附属文件是等你真的需要分层的时候才加的东西,不是凑数的格式要求。先薄后厚,比一上来就搭三层目录靠谱得多。
四、四个问题,决定一块内容留着还是挪出去判断表来了。我没在文档里找到一张现成的"该留该挪"对照表,但文档里的线索足够折成四个问题,按顺序问。
问题一:这一块内容,是不是每一次用这个 Skill 都会用到?
是——留在正文。不是——挪出去。
拿 py-style 举例:命名规范每次都用得到,日志规范一个月用不到一次。日志那一段就没有资格待在正文里。
这里的"每一次"要按最常见的那个用法去算,不是按"理论上可能"。你把所有场景都算上,那什么都用得到,这张表就白问了。问的是:这个 Skill 被叫起来十次,有几次会碰到它?
问题二:这一块是不是又长又少用?
"长"加"少用"同时成立,它就不该躺在正文里。正文只留一行指路。
注意判据是"少用",不是"不重要"。日志规范当然重要,但它的重要性不决定它放在哪个文件里。很多人拆不下去,就是因为舍不得——"这条很重要啊",可重要和常驻是两个维度。
问题三:这一步能不能写成确定性代码?
能——写成脚本。可重复、可测试,还不吃 token。别让模型每次现编。
判断"能不能写成代码"有个土办法:这件事有没有唯一正确答案? 有,就是脚本。命名合不合规有唯一答案,导入顺序对不对有唯一答案,一个字段有没有脱敏有唯一答案。这些东西交给自然语言就是浪费,而且不可靠。
问题四:这一段是不是在解释"为什么",而不是"做什么"?
官方那句 State what to do rather than narrating how or why 就是判据。解释性、背景性、历史性的内容,挪进参考文档。正文只留指令。
把四个问题合成一张表:
这块内容的特征
放哪儿
为什么
每次都用到
SKILL.md
正文
反正要用,早点拿省一次往返
长,且只在某个分支下用
附属文档
用到才读,不用不花钱
有唯一正确答案的步骤
scripts/
脚本
确定、可测、输出短
在解释原因、背景、历史
附属文档
不是指令,不需要常驻
再补一条使用顺序上的经验:问题一先问,问题四最后问。因为问题一决定的是"要不要动",问题三和问题四决定的是"往哪儿动"。反过来先想往哪儿搬,最后往往是把内容从一个地方搬到了另一个也不合适的地方,白搬一趟。
四个问题问完,你会发现大部分 SKILL.md 的体量问题都不是"东西太多",而是"东西放错了层"。内容本身没有错,错在它被放在一个每一轮都要付费的位置上。
换个位置,同样的内容就从负债变成了资产。
还有个更土的办法,比四个问题都快:把 SKILL.md 从头到尾读一遍,读到某一行的时候问自己——这一行如果明天删掉,会不会有人发现? 发现不了的那些行,就是该挪走的行。
拆完之后的验收标准也很简单:正文通读一遍,你能在三句话之内说清这个 Skill 是干什么的;把附属文件全部拿走,正文依然能独立跑通最基本的那个场景。这两条都做到,结构就是对的。
五、一个完整的目录,逐行拆开看拿一个具体的例子。假设要重写那个 py-style,结构大概是这样:
py-style/
├── SKILL.md
├── reference/
│ ├── naming.md
│ └── logging.md
├── examples/
│ └── good-vs-bad.md
└── scripts/
└── check_style.py逐个说职责。
SKILL.md——只写三件事:这个 Skill 是干什么的、什么时候用它、以及一份附属文件清单。清单这一项最容易漏,也最重要,第六节专门讲。
reference/naming.md——命名的全部细则。为什么单独一份?因为它和日志是两个几乎不会同时出现的场景:写业务逻辑的人碰命名,排查问题的人碰日志。
reference/logging.md——日志的全部细则。级别怎么选、什么该记什么不该记、敏感信息怎么脱敏。
examples/good-vs-bad.md——成对的代码片段,一段好的配一段坏的。这个东西对模型特别管用,一段示例胜过三段描述。但要写对:例子里得能看出边界,只给"好代码",模型学不到"什么样的不该写"。
scripts/check_style.py——把能确定性判断的东西写成脚本:导入顺序对不对、命名合不合规、有没有裸 except。Claude 只要跑一遍,拿回一份短报告。
那么 SKILL.md 自己长什么样?大概是这样:
---
name: py-style
description: 项目的 Python 编码风格。写或改 Python 文件、新增模块、评审代码时使用。
---
## 什么时候用
写新的 Python 模块、修改已有函数、评审别人的 Python 代码时。
## 必须遵守的几条
- 模块名小写下划线,类名大驼峰,函数名小写下划线
- 不用裸 except,捕获要指明异常类型
- 公开函数必须有类型标注
- 日志用 logging,不用 print
## 附属文件
- 命名细则见 reference/naming.md —— 新增模块或函数时读
- 日志细则见 reference/logging.md —— 涉及打日志、改级别时读
- 正反例见 examples/good-vs-bad.md —— 不确定某段写法是否合规时读
- 跑 scripts/check_style.py 可直接查出导入顺序与命名问题这就是一份完整的、能用的 SKILL.md。注意它没有写:为什么用 snake_case、日志有哪些级别、什么样的写法算反例。那三块全在附属文件里等着。
现在说第一个数字:正文该多长。
官方在附属文件那一节给了一条建议,就一句话:
Keep
SKILL.md
under 500 lines. Move detailed reference material to separate files.
500 行以内。 为什么是 500?因为正文长度直接决定每次触发之后的固定成本。这个数字不是"写得下多少"的问题,是"每次要付多少"的问题。
有了这个上限,上面那份结构里 SKILL.md 该落在什么区间就很清楚了:一百行上下。三件事写完差不多就是这个量。如果你的一份 SKILL.md 写到 200 行还没写到附属文件清单,基本可以断定有一部分内容放错了层。
顺便也说一下另一头:别为了短而短。 有些东西就是该在正文里——那些每次都要遵守的硬约束,删掉一条就少一条约束。把正文压到二十行、指令缺三落四,那不叫结构好,那叫没写完。500 行是上限,不是目标;区间是一百行左右,不是十行。
还有个小细节:SKILL.md 本身是有 frontmatter 的,name 和 description 就写在里面。所以那 500 行的预算里是包含这几行元数据的。这不影响什么,但如果你在数行数的时候把 frontmatter 忘掉,容易正好卡在边界上。
再说第二个数字,路径。
SKILL.md 里写附属文件,别写相对路径去猜位置。官方提供了一个变量:
${CLAUDE_SKILL_DIR}
—— The directory containing the skill's
SKILL.md
file.
它指向 SKILL.md 所在的那个目录。写在正文里,路径就永远对得上,不用管这个 Skill 最后被装在个人目录、项目目录还是别的什么地方。
官方文档里还有一个配套用法,很值得抄:
---
name: render-chart
description: Render a chart from a CSV file
allowed-tools: Bash(${CLAUDE_SKILL_DIR}/scripts/render.sh *)
---
Run `${CLAUDE_SKILL_DIR}/scripts/render.sh ` to render the chart.同一个变量出现在两个地方:正文里告诉 Claude 跑哪个脚本,allowed-tools 里授权那条命令。两边写的是同一个路径,于是这条命令跑起来不会弹确认。
这个技巧的关键在于两边一致。allowed-tools 匹配的是正文里那条确切的命令,路径写法一旦对不上,权限就不生效——你以为授权了,实际每次都在弹窗。
顺带记一下:${CLAUDE_PROJECT_DIR} 这个变量需要 Claude Code v2.1.196 或更高版本。
六、怎么指向附属文件,以及四个反模式拆完之后还有一步不能省:在 SKILL.md 里把附属文件指出来。
官方原话:
Reference supporting files from
SKILL.md
so Claude knows what each file contains and when to load it.
注意这句里的两个要素,缺一不可:每个文件装了什么,什么时候该读它。官方给的示例长这样:
## Additional resources
- For complete API details, see [reference.md](reference.md)
- For usage examples, see [examples.md](examples.md)翻译进你那份 py-style,清单大概写成这样:
## 附属文件
- 命名细则见 reference/naming.md —— 写新模块、新增函数时读
- 日志细则见 reference/logging.md —— 涉及打日志、改日志级别时读
- 正反例见 examples/good-vs-bad.md —— 不确定某段写法是否合规时读
- 跑一遍 scripts/check_style.py 可以直接查出导入顺序与命名问题四条,每条都回答了"装什么"和"什么时候读"。这才叫有效的指路。
顺便回答一个常见疑问:什么时候该让模型自己去找附属文件?答案是——你不写,它就不会去找。这不是模型的懒惰,是它根本不知道那些文件存在,它看到的只有 SKILL.md 的正文。附属文件对它不可见,除非你在正文里造一根线把它牵过去。
所以判断只有一条:凡是 Claude 应该用到的附属文件,正文里必须有一行提到它。 没有例外。
再往前走一步,还有个问题:什么时候该在正文里把话说死,什么时候可以留模糊?我的经验是——需要跨文件取东西的时候,说死,直接写"读 reference/naming.md"。不需要取文件的时候,可以留活口,让它自己判断。凡是涉及路径和文件名的,一个字都别省。

现在可以列反模式了。四个,你对号入座。
反模式一:把整个知识库塞进 SKILL.md。
正文 800 行,每次触发都往上下文里灌一本书。这个最常见,因为动机是好的——"我全都写上,它就不会漏了"。结果正好相反。
判断自己有没有犯:看正文里有没有大段的背景介绍、历史沿革、术语解释。有,就是它。
反模式二:附属文件写了,但 SKILL.md 里一个字都没提。
这是最难自查的一个。因为你自己清楚那些文件装了什么,很难意识到别人看不见——这里的"别人"就是 Claude。文件安静地躺在磁盘上,模型永远不知道它在,等于不存在。
自查办法:把 SKILL.md 单独复制出来,只看它,猜那些附属文件分别装了什么。猜不出来,就是没写清楚。
反模式三:本该写成脚本的确定性步骤,写成了自然语言步骤。
"先按字母顺序整理导入,再去掉重复的,然后检查每个函数名是否符合规范"——这三步写成文字,模型每次执行都可能不一样,而且你没法测。写成一段三十行的脚本,一切就固定了。
这个反模式还有个隐蔽版本:步骤确实写对了,但它是那种"跑十次对八次"的步骤。八次也够用,于是就留下来了。等到某一次它没跑,你在一个完全不相干的地方看到后果,还找不到原因。
反模式四:附属文件之间互相矛盾。
两份参考文档对同一个问题给出不同结论,Claude 会挑一个,你也不知道它挑了哪个。这个坑在多人维护的 Skill 里特别常见,因为没有人会同时读两份附属文件。
这个反模式的解法是结构性的:同一件事只在一个地方定义。 命名规则只在 naming.md 里说一遍,别的地方要提就指过去,别再抄一遍。抄一遍就多一个走样的机会。
顺带说一个相邻的坑:文档里专门有一节讲"Skill 描述被截断"的问题——description 加 when_to_use 合并后在 1536 字符处截断。第 2 篇讲过这个数字。这里只补一句:正文太长会间接影响触发质量,因为描述和正文是同一份文件里的两段东西,写正文的时候顺手把描述也写飘了,是常有的事。
七、把那个 300 行的 Python 风格 Skill 拆开回到第 2 篇。那篇里我们用过一个「Python 代码风格」Skill 当例子,当时它是一份 300 行的单文件。现在按上面的四个问题拆一次,动作全部写出来。
拆之前:python-style/SKILL.md,300 行。里面大致五块内容——命名规范约 60 行、日志规范约 70 行、异常处理约 40 行、正反例约 80 行,还有一段 50 行的"检查清单"(导入顺序、裸 except、命名合规)。
第一步,问问题四。 哪些是在解释"为什么"?命名那段里大篇幅讲"为什么用 snake_case 不用 camelCase",日志那段讲"我们当初为什么从 print 换到 logging"。这些全是 why,约 90 行,进参考文档。注意这里不是把整段搬走——留下的是"用 snake_case"这一条指令,搬走的是后面那半页论证。
第二步,问问题一。 哪些不是每次都用?日志规范整块。写业务代码的人一个月碰不到一次日志配置。约 70 行进 reference/logging.md。异常处理那 40 行留在正文,因为每一段代码都涉及异常。
第三步,问问题三。 那段 50 行的检查清单,"导入顺序、裸 except、命名合规"三条,全都能确定性判断。写成脚本。50 行自然语言变成约 80 行 Python,但正文里只多一行——换来的是每次都能一致地跑,而且跑完只回一份短报告。
第四步,问问题二。 正反例那 80 行又长又只在"不确定时"才看,进 examples/good-vs-bad.md。
拆之后:
python-style/
├── SKILL.md (90 行)
├── reference/
│ ├── naming.md (命名细则 + 为什么这么定)
│ └── logging.md (日志细则 + 级别选择)
├── examples/
│ └── good-vs-bad.md (成对的正反例)
└── scripts/
└── check_style.py (导入序 / 裸 except / 命名合规)把行数摊开看:
原来
现在
去了哪
60 行命名
20 行正文 + 40 行参考
论证部分挪走,指令留下
70 行日志
0 行正文 + 70 行参考
整块挪走
40 行异常
40 行正文
原地不动
80 行正反例
0 行正文 + 80 行示例
整块挪走
50 行检查清单
1 行正文 + 80 行脚本
变成可执行的东西
—
约 29 行附属文件清单与说明
新增
300 行正文
90 行正文
其余 210 行换了个位置
SKILL.md 从 300 行变成 90 行。删掉的内容一行没少,只是从"每一轮都付费"挪到了"用到才付费"。那个 80 行的脚本比原来的 50 行还长——但它跑的时候只回五行。
这份 90 行的正文,结构上就是三段:
这个 Skill 干什么、什么时候用它(约 20 行)风格指令本体——每次都要用的那几十条(约 45 行)附属文件清单,四条(约 10 行)第三段最容易被省略,也最不能省。少了它,前面两个文件夹就是三份死文件。
拆完那天我做的第一件事是拿它跑了三种任务:只写业务函数、改日志、评审一段烂代码。第一种只读了 naming.md,第二种只读了 logging.md,第三种读完示例又跑了脚本。三种任务里,正文之外被读到的文件都不一样——这就对了,说明分层真的在起作用。
官方文档里有一段关于上下文压缩的话,放在这里对照着看很有味道:会话被自动压缩时,Claude Code 会把每个 Skill 最近一次调用的内容重新挂回去,每个保留前 5,000 token,所有重新挂上的 Skill 共享 25,000 token 的预算,并且从最近调用过的那个开始填。也就是说,你那份正文要是本身就有五千 token,压缩一次之后,它保留下来的可能已经是你全部的家当了。
拆分的收益,最后都落在这一类地方。
最后说个数:我把手上那个 812 行的 SKILL.md 拆到 92 行,触发后的固定成本掉了将近九成。你的现在多少行?
下一篇解决的是下一个问题:结构拆好了,它怎么进到团队每个人的机器里。具体到你会撞上的那几件事——放在 ~/.claude/skills/ 里,同事永远拿不到;放进项目仓库,又会跟每个人的个人偏好打架;就算位置都放对了,改一次要让所有人拿到新版本,中间还隔着一层信不信得过的判断。这篇拆的是文件,下篇拆的是路径和权限。