
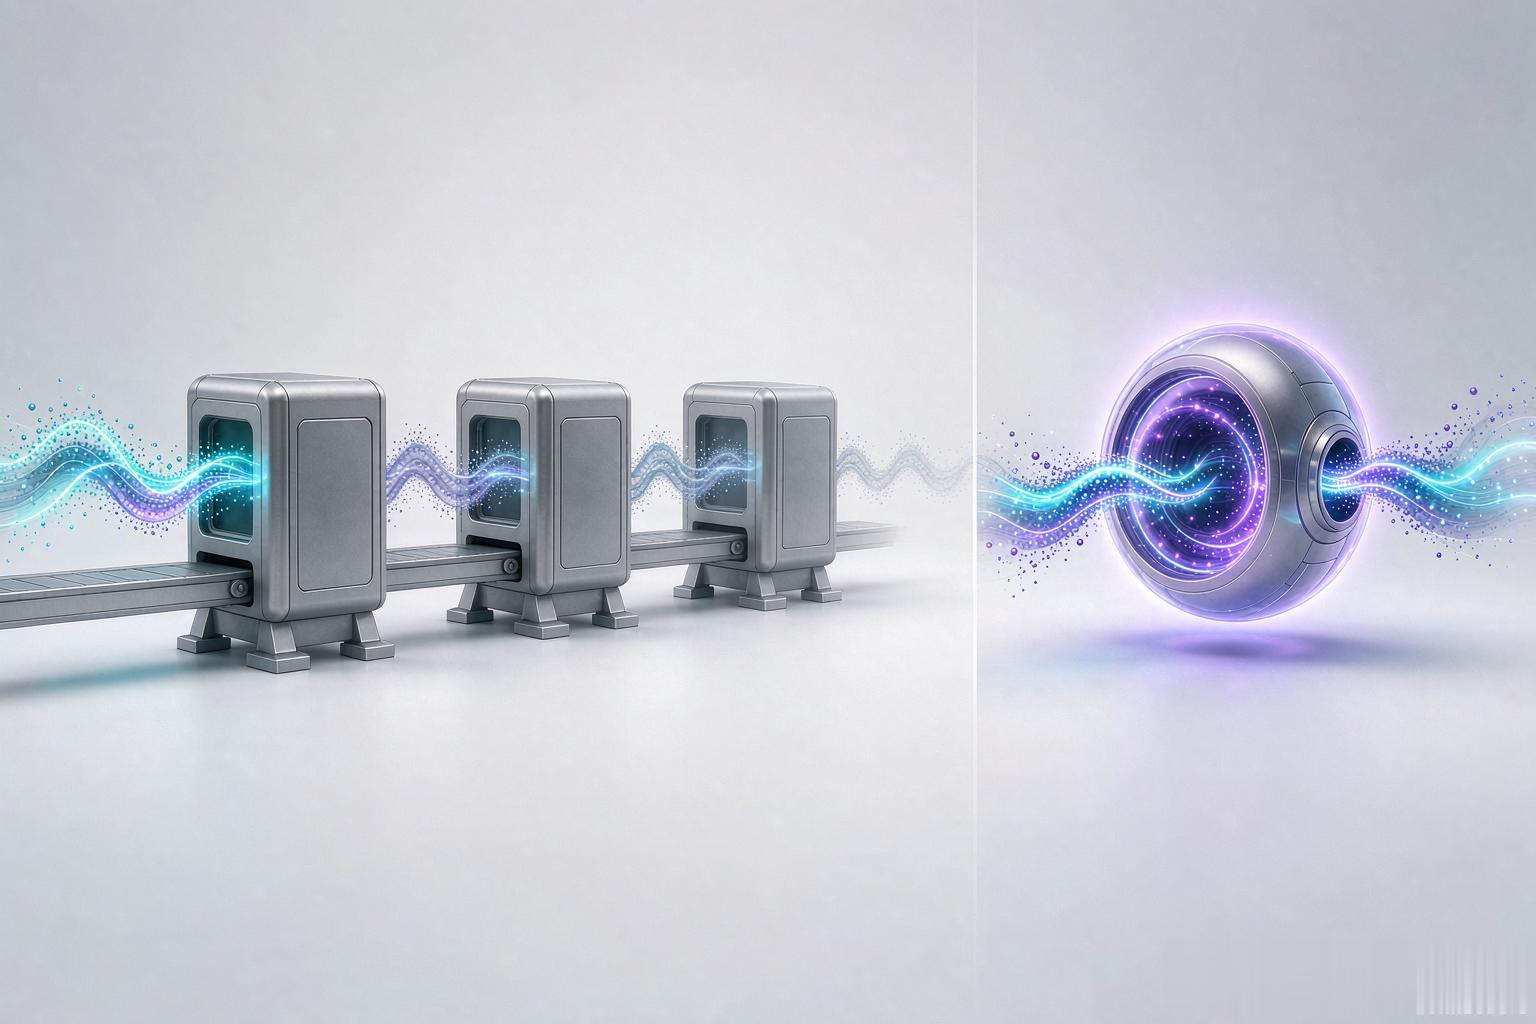
先说清楚,这次发的到底是什么很多人对语音助手的印象还停留在"说话转文字,文字丢给大模型,回答再转回语音"。这套流水线业内叫级联方案,一个语音Agent背后站着三个模型,各干各的。问题出在交接。每一棒交接都要排队,一套级联链路跑下来,延迟大概在450到1000毫秒。你在电话里跟客服机器人打过交道就知道,那段短暂的沉默有多尴尬。还有个更隐蔽的损失:转写那一步会把语调、犹豫、加重音这些信息全抹掉,剩下的干巴巴文字丢给大模型,模型只能靠猜来理解你到底想干嘛。Gemini 3.8 Live这回走的是另一条路:音频进去,音频出来,中间砍掉了转写那一步,官方目标把端到端延迟压到200毫秒以内。打断也顺了,你说到一半插话,它不会傻等你说完。对做语音产品的开发者来说,这才是体验上的分水岭。能力清单里有几项我盯着看了很久。一个是视觉上下文,用户可以举着手机摄像头边指边问,模型实时看画面回话,音频加视频场景就为这个准备的。另一个是字符精度,报确认码、订单号、验证码这种事,历来是语音系统翻车的高发区,这回专门做了强化。再一个是97种语言能中途自动切换,用户说着说着换了语言,对话不用重来。还有个细节挺意外,官方模型卡里写明这两个型号的底座都是Gemini 3 Pro。拿旗舰模型当语音底座,谷歌这回没省料。
评测数据,我先泼半盆冷水第三方机构Artificial Analysis的语音质量指数里,Extended Thinking版拿了82.6分,比GPT-Live-1的81.5高出1.1分。看着挺爽,但有两件事得说在前面。一是OpenAI那个分数只有单次试验,多数模型要跑三次取结果,误差不小。二是细分榜各有输赢:音频推理基准Big Bench Audio拿到97.7%,客服任务完成率τ-Voice是68.6%对67.9%,谷歌赢;可打断与停顿处理这项Full Duplex Bench,谷歌91.9%,OpenAI拿94.9%,反而是对面赢。首音延迟两边几乎打平,1.35秒对1.34秒。我的读法:综合质量确实领先,但没拉开代差,别被"碾压"这类标题带跑。选型的时候拿自己的真实场景测一遍,比看榜单靠谱得多。顺带提醒一句,这两个型号都是托管服务,不开源权重,想私有化部署的朋友可以直接划走。也正因为是API形态,谷歌更新起来没有任何心理负担,哪天出个3.9把价格再调一调,你签的长期合同就得重新算。做生产环境的话,把模型名做成配置项,别写死在代码里,这是我从上次DeepSeek切换路由那次学来的习惯。
重点来了,账单怎么算谷歌的价目表其实只有一张:音频输入每百万token 3美元,约合每分钟0.005美元;音频输出每百万token 12美元,约合每分钟0.018美元。文字输入0.75美元、输出4.50美元每百万token,图像视频输入1美元每百万token。两个型号挂同一张价目表,AI Studio里还有免费额度可以先试。粗算一下,一通10分钟的咨询电话,光音频输入大概3美分出头,输出看话多话少,整体在人民币几毛钱的量级。这个单价放在语音客服赛道,已经能掰着指头算回本了。
但真跑起来,账单差得很远。Artificial Analysis拿同一套任务实测,标准版每小时输入音频成本0.84美元,Extended Thinking是3.50美元,差了四倍多。原因在思考token。Extended Thinking会边说边想,那些推理过程全按输出价计费。价目表看着一样,发票差四倍,谷歌没把这个差异印在价目表上,这是我全篇想提醒的头一号坑。按这个单价,媒体给过一组参考量级:一个月跑一万小时语音的客服系统,用GPT-Live-1大概5.83万美元,换Extended Thinking约3.5万美元,能省四成;业务简单的话换标准版只要8400美元。数字来自第三方测算,各家任务分布不一样,仅供参考。
上车之前,三个坑先记下
头一个,会话有时长限制。纯音频单场15分钟,音频加视频只有2分钟,长对话得自己做会话恢复逻辑,128K的上下文窗口也要盯着,别让长会话悄悄断掉。再一个,工具调用的坑。标准版支持异步调用,Extended Thinking只支持异步模式。好处是查数据库、调接口的时候语音不中断,模型会边干边汇报进度,跟用户说一句"稍等,我查一下"然后真的在查;但你的架构得按异步来设计,同步思维直接套上去会撞墙。接入层面走的是WebSocket长连接,音频按16kHz的PCM格式进、24kHz出,流式推拉都要自己搭。还有一个,97种语言中途自动切换是个亮点,可所有输出音频都带SynthID水印。做正经商用产品这不算事,想做变声类工具的就得掂量掂量了。
我会怎么选逻辑不复杂:热线客服、前台接待这类讲究流畅的场子,选标准版,便宜六成多,任务完成率也不差;要边聊边做多步任务的,比如电话里帮用户改订单查物流,再上Extended Thinking,为思考token付这份溢价。音色可以在speechConfig里随便换,TTS那边支持的音色它都认,同一套业务换个人设不用换模型。要是嫌自己搭音视频流麻烦,官方列了一圈集成伙伴,Agora、LiveKit、Pipecat、LangChain这些都有现成管道,例子代码在GitHub上能翻到。至于国内小程序接入,老问题还在:支付、网络、合规。谷歌API在国内直连不稳,中间得搭一层代理,这部分成本和延迟要提前算进去。想先零成本体验的,AI Studio网页里直接就能试,一行代码不用写。顺带说句行业观察。9月这波发布潮确实凶,Fable 5.1、GPT-6 Astra、V4.1 Flash、Grok 4.7接连落地,语音这块卷得尤其快。原因也好理解,客服、智能硬件、口语陪练,语音是AI落地收钱节奏很快的场景之一,谁都不敢松手。对咱们这种小团队开发者,反而是好事:巨头把单价打下来,咱们才有机会在夹缝里做出点能收钱的小产品。我把两个型号的接入文档都翻完了,过两天拿自己小程序的客服场景实测一版账单对比。想看的评论区扣个1,人多的话下周就出实测篇。
#AI# #Gemini# #语音AI# #大模型# #开发者# #AI工具#